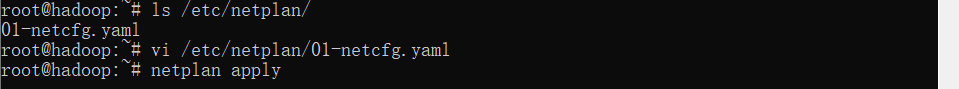这篇记录整理单节点 Hadoop 与 Spark 环境的搭建过程。整体目标是在一台云服务器上完成 JDK、Hadoop、HDFS、YARN、MapReduce、Spark、spark-submit 和 PySpark/Jupyter 的基本验证。
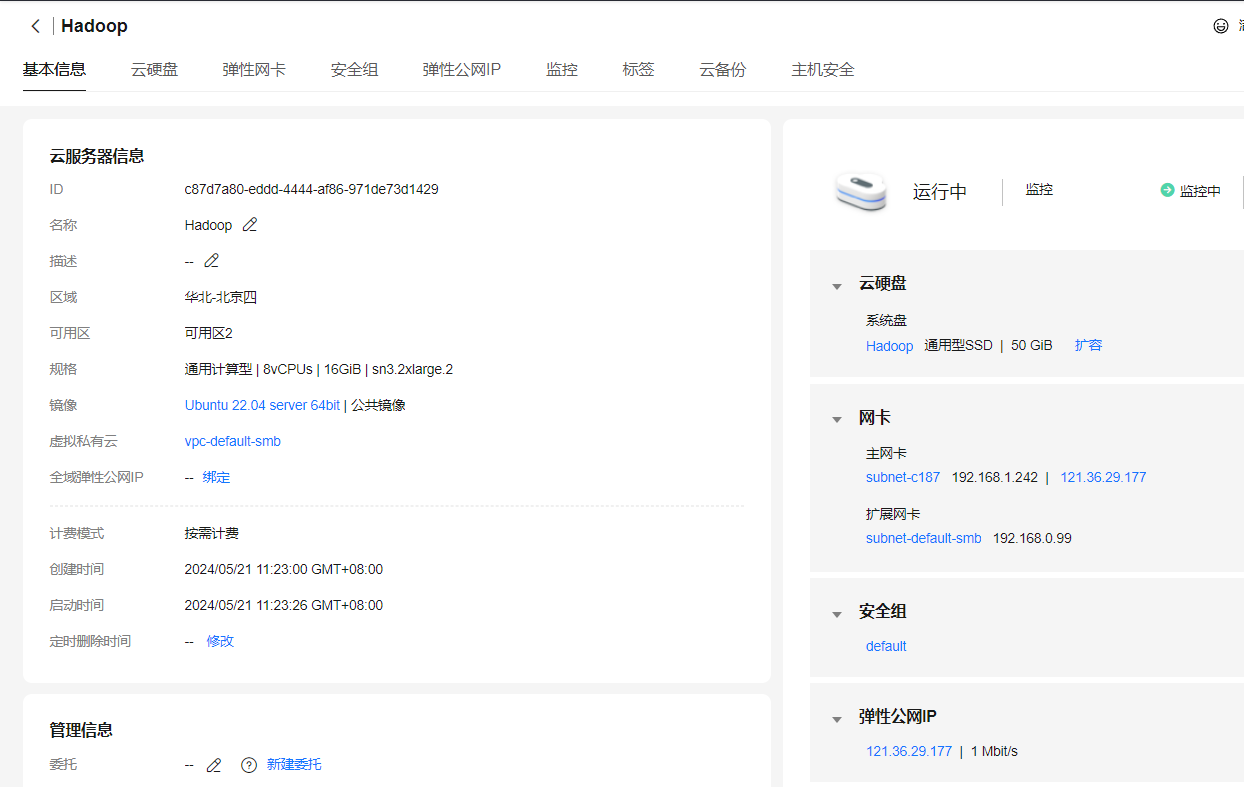
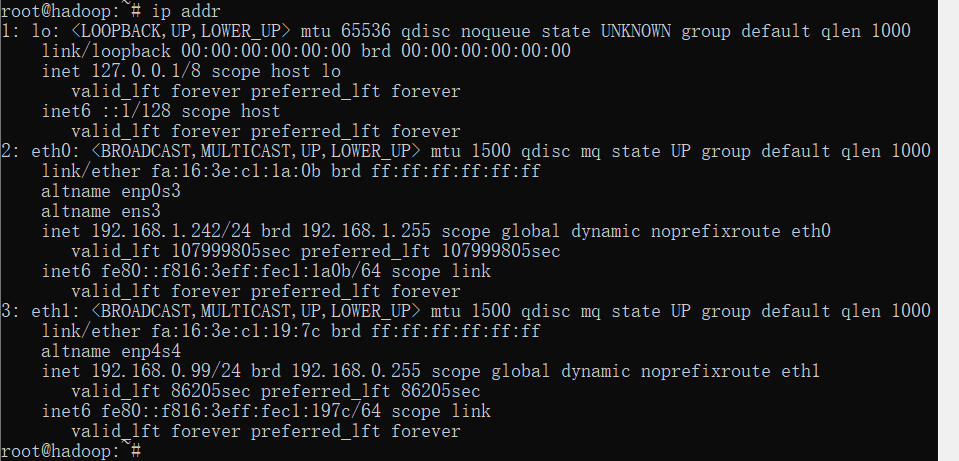
这次使用华为云服务器完成搭建,配置为 8 核 16G 内存。整个过程中只有一个节点 node01,因此以单节点伪分布式方式运行 Hadoop 和 Spark,服务器的详细配置如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# ls /etc/netplan/ # vi /etc/netplan/01-netcfg.yaml network: version: 2 ethernets: ens3: dhcp4: false match: macaddress: fa:16:3e:b1:41:1c set-name: ens3 addresses: [192.168.1.101/24] routes: - to: default via: 192.168.1.1 metric: 100 nameservers: addresses: [202.201.0.131,202.201.0.132] # netplan apply
1
2
3
4
5
6
7
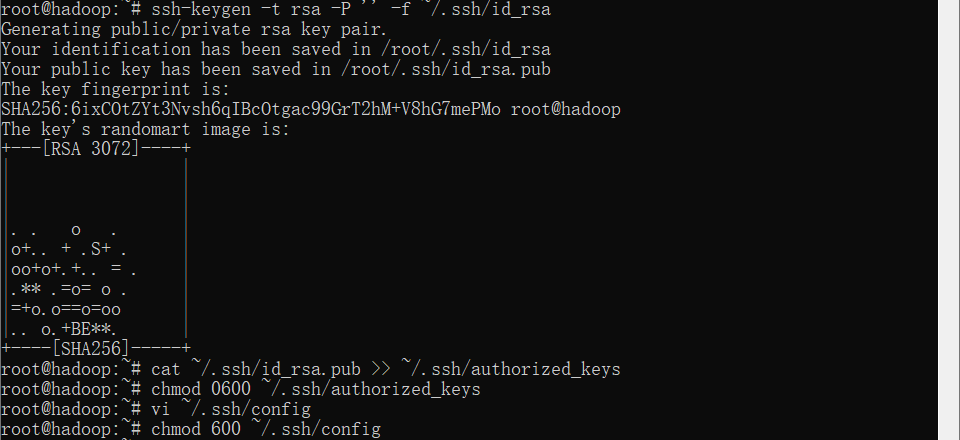
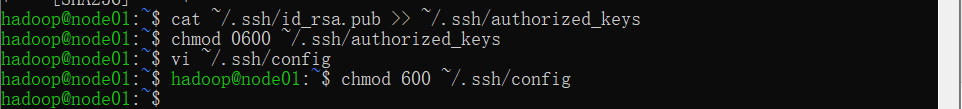
# ssh-keygen -t rsa -P '' -f ~/.ssh/id_rsa # cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys # chmod 0600 ~/.ssh/authorized_keys # vi ~/.ssh/config Host * StrictHostKeyChecking no # chmod 600 ~/.ssh/config
1
2
3
4
5
6
# vi /etc/hosts 127.0.1.1 localhost 127.0.1.1 hadoop hadoop 127.0.1.1 node01 192.168.1.242 node01 # hostnamectl set-hostname node01
华为云服务器本身设置了时区和时钟同步,不需要额外设置
详细设置可以参考之前的实验
1 # timedatectl set-timezone Asia/Shanghai
1
2
3
4
5
6
7
8
9
10
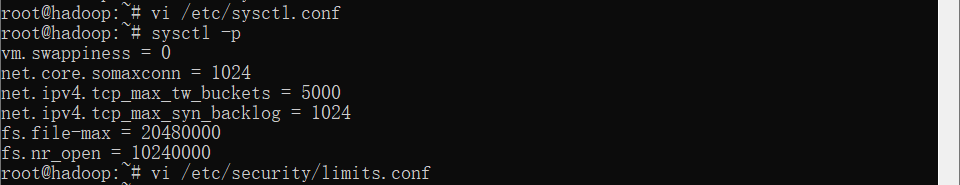
# vi /etc/sysctl.conf fs.file-max = 20480000 fs.nr_open= 10240000 # sysctl -p # vi /etc/security/limits.conf root soft nofile 102400 root hard nofile 104800 * soft nofile 102400 * hard nofile 104800 # reboot
1
2
3
4
5
# systemctl set-default multi-user.target # systemctl disable cloud-config.service cloud-final.service cloud-init-local.service cloud-init.service cloud-init-hotplugd.socket cloud-config.target cloud-init.target multipathd.service multipathd.socket iscsid.socket apparmor.service systemd-resolved.service ufw.service fwupd.service graphical.target cron # rm /etc/resolv.conf # vi /etc/resolv.conf nameserver 202.201.0.132
最后升级一下系统
1 # apt update && apt upgrade -y
1
2
3
4
5
6
7
8
9
10
# adduser hadoop # sudo su - hadoop hadoop@node01:~$ $ ssh-keygen -t rsa -P '' -f ~/.ssh/id_rsa $ cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys $ chmod 0600 ~/.ssh/authorized_keys $ vi ~/.ssh/config Host * StrictHostKeyChecking no $ chmod 600 ~/.ssh/config
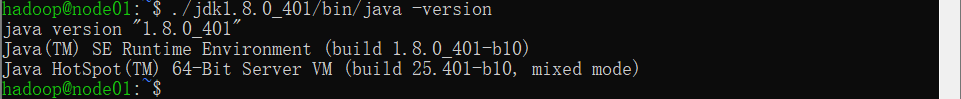
在hadoop用户下完成jdk8的安装配置:
1
2
3
$ wget http://bigdata.cg.lzu.edu.cn/bigdata_software/jdk-8u401-linux-x64.tar.gz $ tar -zxvf jdk-8u401-linux-x64.tar.gz $ ./jdk1.8.0_401/bin/java -version
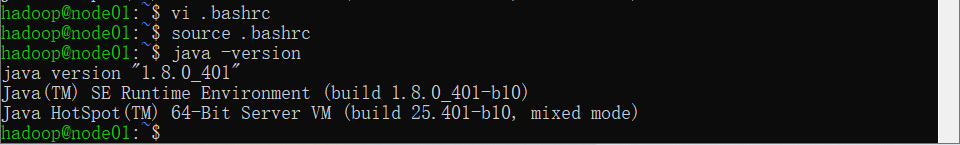
在.bashrc文件中添加jdk8环境变量
1
2
3
4
5
6
$ vi .bashrc export JAVA_HOME=/home/hadoop/jdk1.8.0_401 export PATH=$JAVA_HOME/bin:$PATH export CLASSPATH=.:$JAVA_HOME/jre/lib:$JAVA_HOME/lib:$JAVA_HOME/lib/tools.jar $ source .bashrc $ java -version
因为我们只有一个节点node01,所以到这里java环境就配置完毕了,不需要将jdk8包和修改后的环境变量scp到其他节点。
下载hadoop-3.3.6二进制包,解压
1
2
$ wget http://bigdata.cg.lzu.edu.cn/bigdata_software/hadoop-3.3.6.tar.gz $ tar -zxvf hadoop-3.3.6.tar.gz
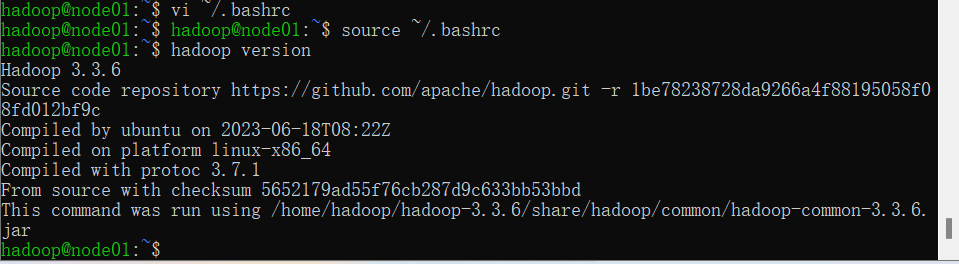
设置haodoop环境变量
1
2
3
4
5
6
7
8
9
10
11
$ vi ~/.bashrc export HADOOP_HOME=/home/hadoop/hadoop-3.3.6 export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin export HADOOP_MAPRED_HOME=$HADOOP_HOME export HDFS_NAMENODE_USER=hadoop export HDFS_DATANODE_USER=hadoop export HDFS_SECONDARYNAMENODE_USER=hadoop export YARN_RESOURCEMANAGER_USER=hadoop export YARN_NODEMANAGER_USER=hadoop $ source ~/.bashrc $ hadoop version
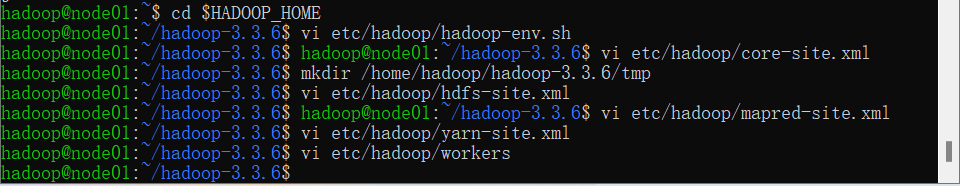
修改hadoop配置文件:
1
2
3
4
5
$ cd $HADOOP_HOME $ vi etc/hadoop/hadoop-env.sh export JAVA_HOME=/home/hadoop/jdk1.8.0_401 export HADOOP_HOME=/home/hadoop/hadoop-3.3.6 export HADOOP_CONF_DIR=${HADOOP_HOME}/etc/hadoop
1
2
3
4
5
6
7
8
9
10
11
$ vi etc/hadoop/core-site.xml <configuration> <property> <name>fs.defaultFS</name> <value>hdfs://node01:9000</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/home/hadoop/hadoop-3.3.6/tmp</value> </property> </configuration>
创建tmp目录
1 $ mkdir /home/hadoop/hadoop-3.3.6/tmp
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
$ vi etc/hadoop/hdfs-site.xml <configuration> <property> <name>dfs.namenode.http-address</name> <value>node01:9870</value> </property> <property> <name>dfs.namenode.name.dir</name> <value>/home/hadoop/hadoop-3.3.6/dfs/name</value> </property> <property> <name>dfs.datanode.data.dir</name> <value>/home/hadoop/hadoop-3.3.6/dfs/data</value> </property> <property> <name>dfs.replication</name> <value>1</value> </property> <property> <name>dfs.permissions.enabled</name> <value>false</value> </property> </configuration>
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
$ vi etc/hadoop/mapred-site.xml <configuration> <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> <property> <name>mapreduce.application.classpath</name> <value>$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/*:$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/lib/*</value> </property> <property> <name>mapreduce.admin.user.env</name> <value>HADOOP_MAPRED_HOME=/home/hadoop/hadoop-3.3.6</value> </property> <property> <name>yarn.app.mapreduce.am.env</name> <value>HADOOP_MAPRED_HOME=/home/hadoop/hadoop-3.3.6</value> </property> </configuration>
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
$ vi etc/hadoop/yarn-site.xml <configuration> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> <property> <name>yarn.nodemanager.aux-services.mapreduce_shuffle.class</name> <value>org.apache.hadoop.mapred.ShuffleHandler</value> </property> <property> <name>yarn.resourcemanager.hostname</name> <value>node01</value> </property> <property> <name>yarn.nodemanager.env-whitelist</name> <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value> </property> <property> <name>yarn.nodemanager.vmem-check-enabled</name> <value>false</value> </property> </configuration>
1
2
$ vi etc/hadoop/workers node01
初始文件系统
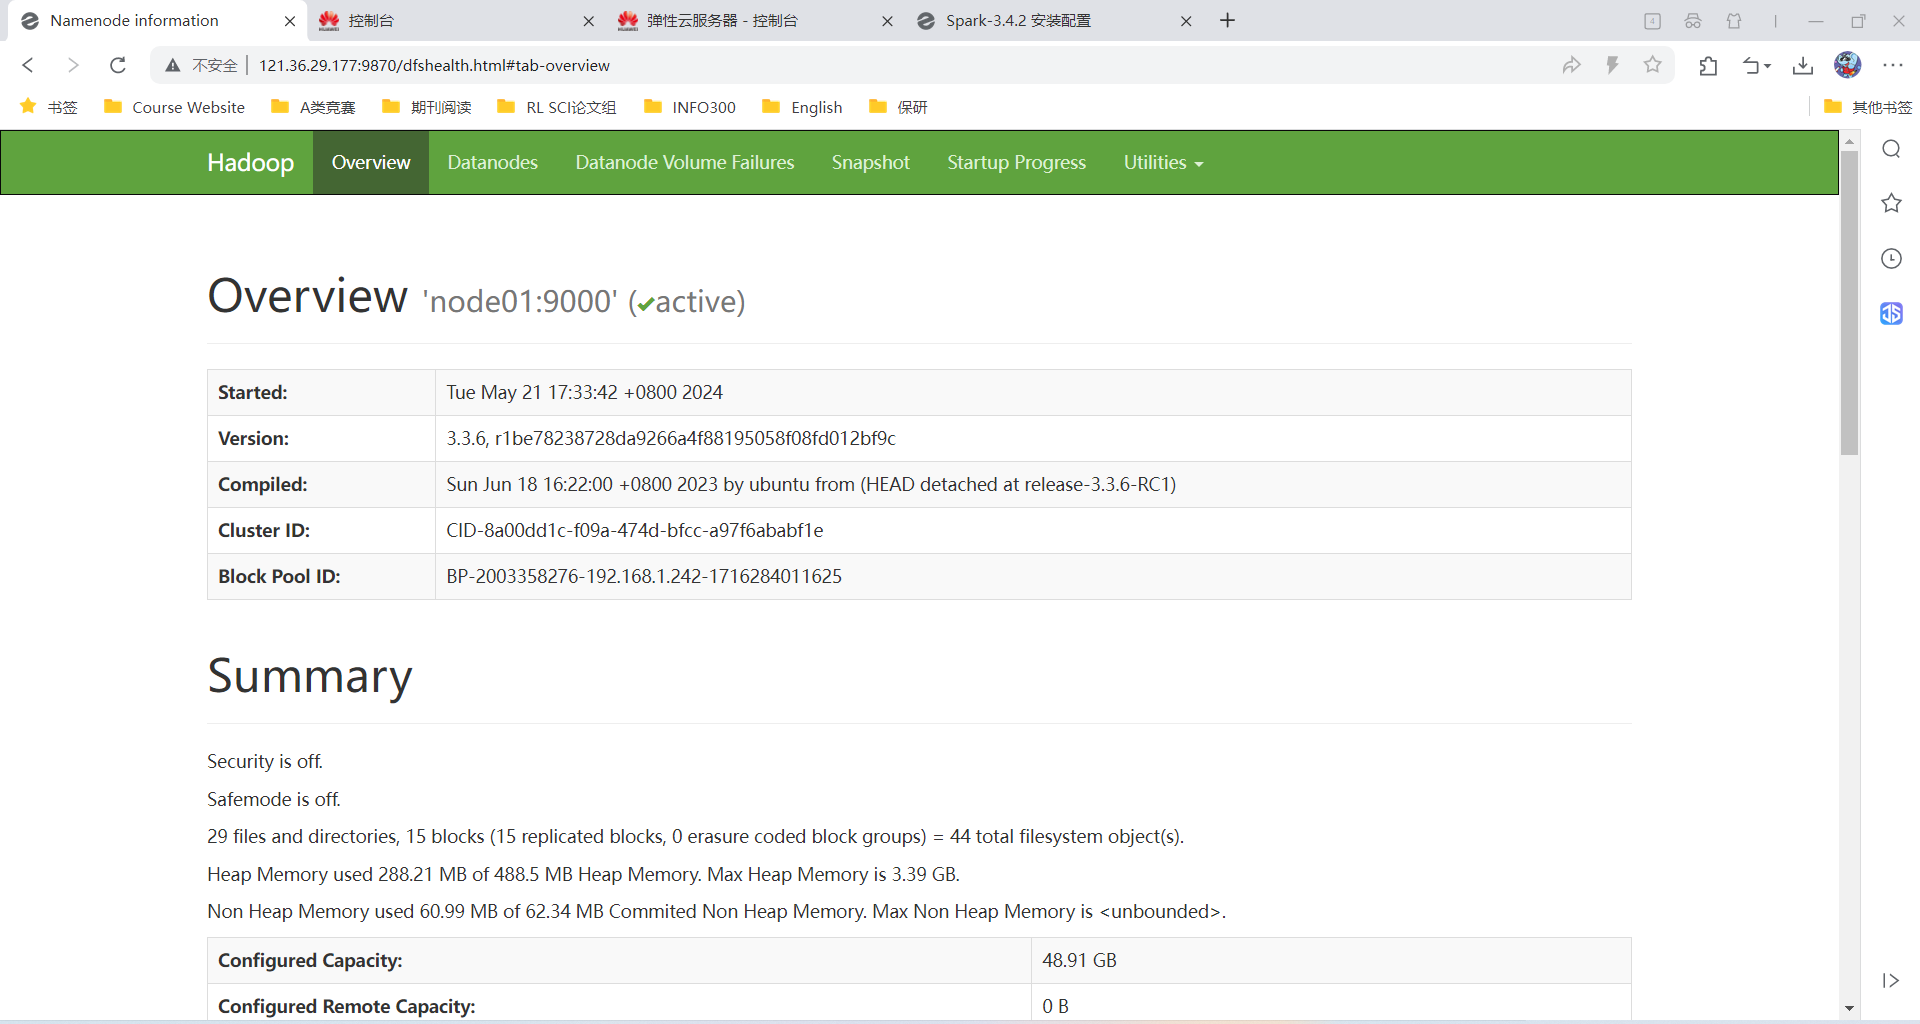
启动分布式文件系统hdfs服务:
第一次启动会创建数据目录和日志目录
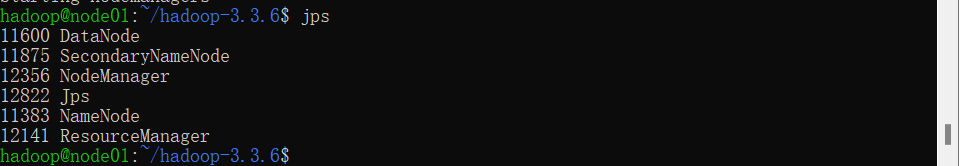
查看进程:
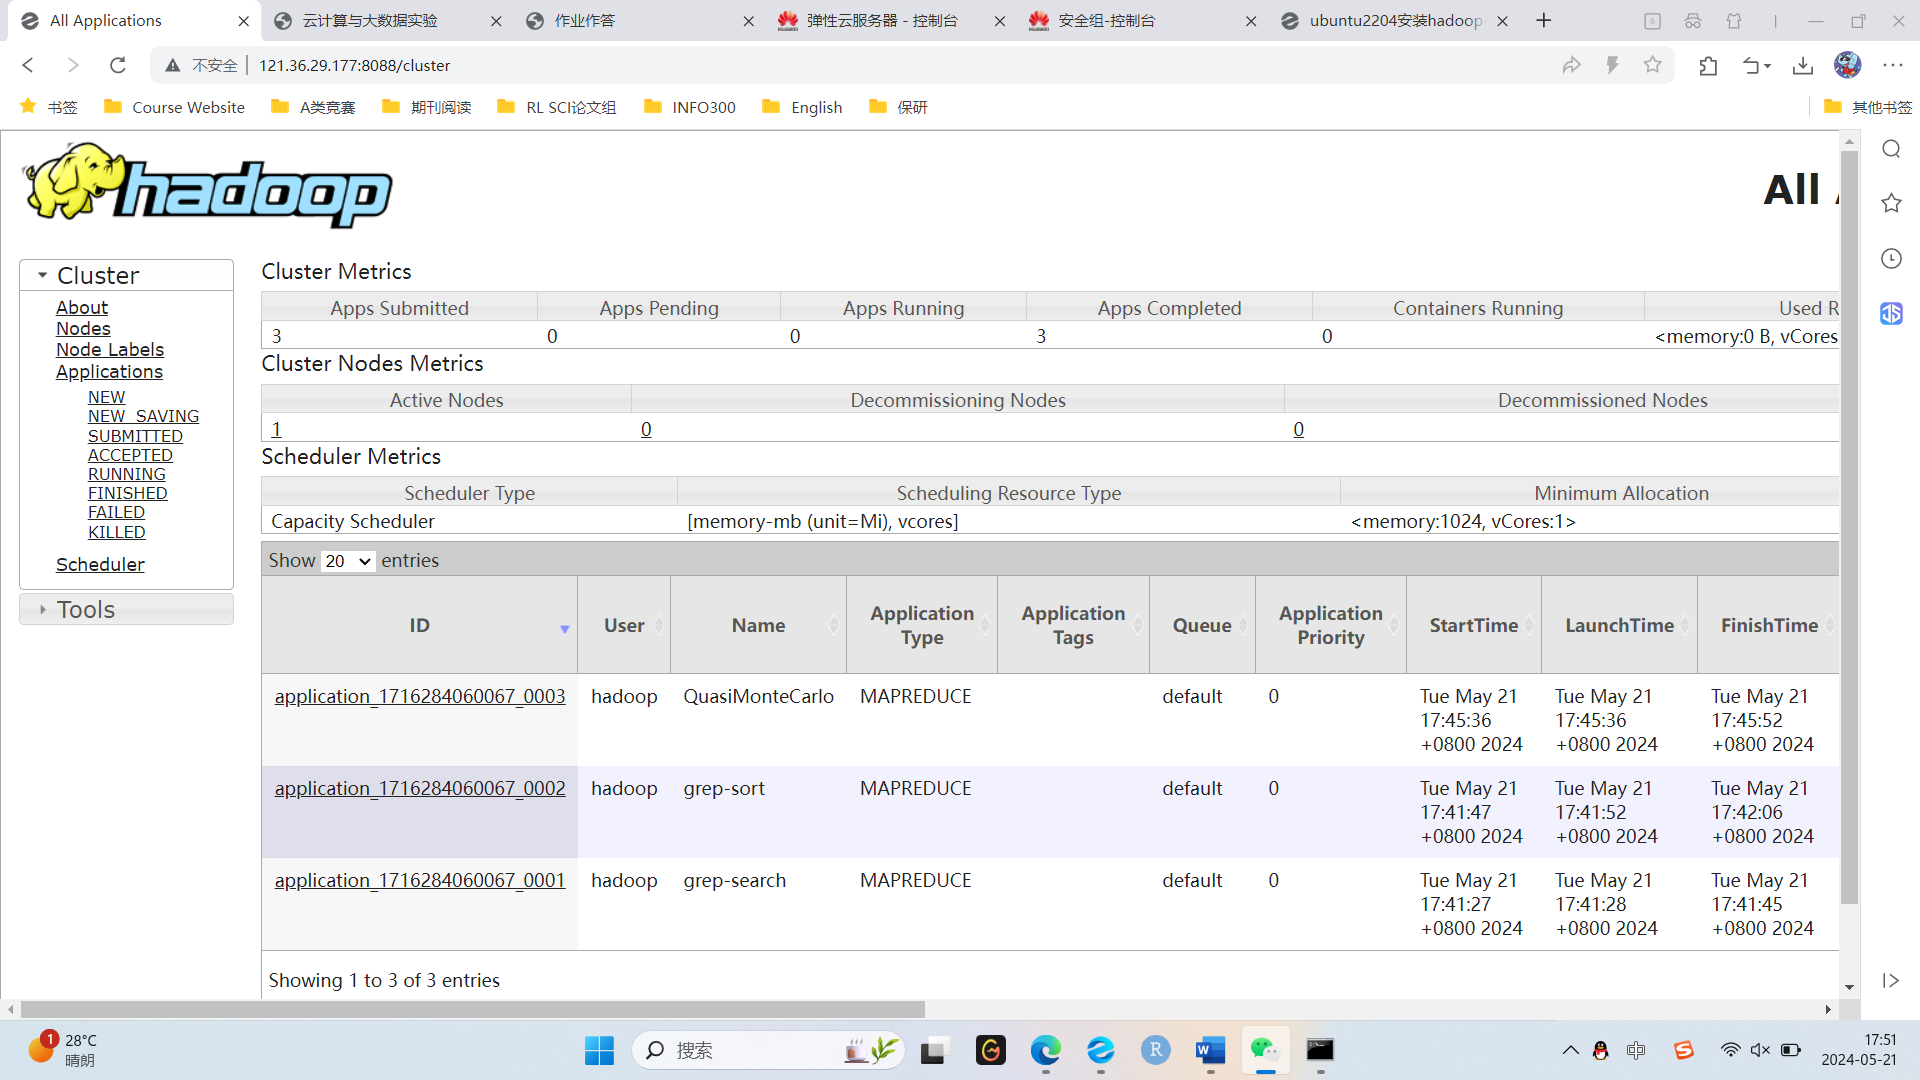
启动资源管理服务yarn:
上述资源启动均成功
资源管理默认web页面为http://node01:8088/
因为这里使用的是云服务,因此这里地址为http://121.36.29.177:8088/
node01交互界面: http://121.36.29.177:9870/
1 2 $ hdfs dfs -mkdir /user $ hdfs dfs -mkdir /user/hadoop
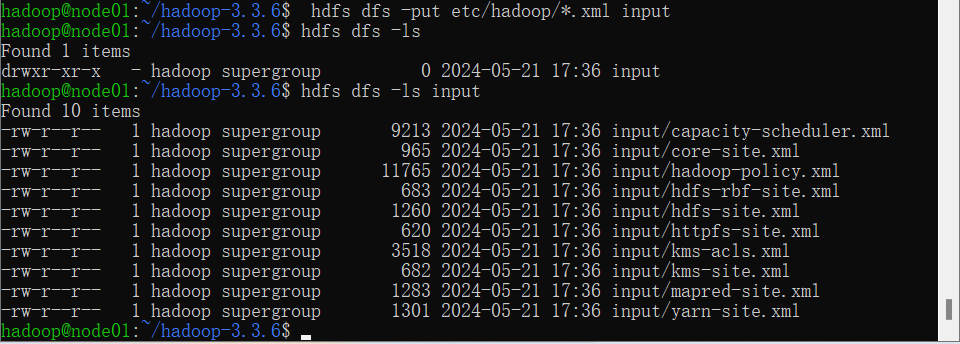
创建input测试目录,上传测试文件:
1 2 3 4 5 $ hdfs dfs -mkdir input $ cd $HADOOP_HOME hadoop@node01:~/hadoop-3.3.6$ hdfs dfs -put etc/hadoop/*.xml input hadoop@node01:~/hadoop-3.3.6$ hdfs dfs -ls hadoop@node01:~/hadoop-3.3.6$ hdfs dfs -ls input
关于hdfs dfs命令可以参考帮助
下面给出hdfs的基本命令以及解释
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 hdfs dfs -ls:列出 HDFS 中的文件和目录。 hdfs dfs -put <local_path> <hdfs_path>:将本地文件上传到 HDFS 中。 hdfs dfs -get <hdfs_path> <local_path>:从 HDFS 中下载文件到本地文件系统。 hdfs dfs -mkdir <hdfs_path>:在 HDFS 中创建一个新目录。 hdfs dfs -copyFromLocal <local_path> <hdfs_path>:从本地文件系统复制文件到 HDFS 中。 hdfs dfs -copyToLocal <hdfs_path> <local_path>:从 HDFS 复制文件到本地文件系统。 hdfs dfs -mv <source_path> <destination_path>:移动文件或目录到新的位置。 hdfs dfs -chown <owner> <hdfs_path>:更改文件或目录的所有者。 hdfs dfs -chgrp <group> <hdfs_path>:更改文件或目录的所属组。 hdfs dfs -chmod <permissions> <hdfs_path>:更改文件或目录的权限。 hdfs dfs -appendToFile <local_path> <hdfs_path>:将本地文件内容追加到 HDFS 文件中。 hdfs dfs -rm <hdfs_path>:删除 HDFS 中的文件。 hdfs dfs -rmdir <hdfs_path>:删除 HDFS 中的空目录。 hdfs dfs -du <hdfs_path>:显示指定目录的大小。 hdfs dfs -expunge:清空 HDFS 中的垃圾文件。
运行例子
1 2 $ cd $HADOOP_HOME hadoop@node01:~/hadoop-3.3.6$ bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.6.jar grep input output 'dfs[a-z.]+'
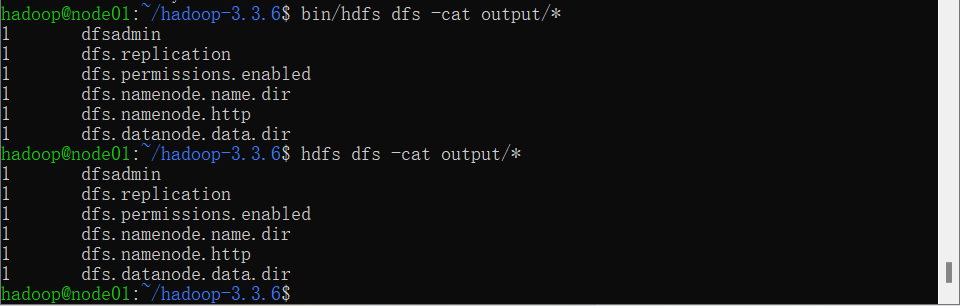
查看输出:
1 2 $ bin/hdfs dfs -cat output/* $ hdfs dfs -cat output/*
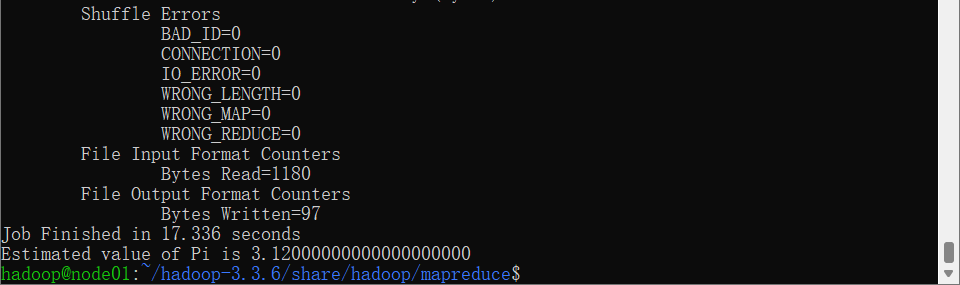
运行pi例子:
1 2 $ cd $HADOOP_HOME/share/hadoop/mapreduce $ hadoop jar hadoop-mapreduce-examples-3.3.6.jar pi 10 20
最后,可以运行以下命令停止服务:
1 2 $ stop-yarn.sh $ stop-dfs.sh
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 $ vi WordCount.java import java.io.IOException; import java.util.StringTokenizer; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.IntWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; public class WordCount { public static class TokenizerMapper extends Mapper<Object, Text, Text, IntWritable>{ private final static IntWritable one = new IntWritable(1); private Text word = new Text(); public void map(Object key, Text value, Context context ) throws IOException, InterruptedException {
StringTokenizer itr = new StringTokenizer(value.toString());
while (itr.hasMoreTokens()) {
word.set(itr.nextToken());
context.write(word, one);
1 2 3 4 5 6 7 8 9 } } } public static class IntSumReducer extends Reducer<Text,IntWritable,Text,IntWritable> { private IntWritable result = new IntWritable(); public void reduce(Text key, Iterable<IntWritable> values, Context context ) throws IOException, InterruptedException {
int sum = 0;
for (IntWritable val : values) {
sum += val.get();
result.set(sum);
context.write(key, result);
1 2 3 4 5 } } public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); Job job = Job.getInstance(conf, "word count");
job.setJarByClass(WordCount.class);
job.setMapperClass(TokenizerMapper.class);
job.setCombinerClass(IntSumReducer.class);
job.setReducerClass(IntSumReducer.class);
job.setOutputKeyClass(Text.class);
job.setOutputValueClass(IntWritable.class);
1 2 3 4 5 FileInputFormat.addInputPath(job, new Path(args[0])); FileOutputFormat.setOutputPath(job, new Path(args[1])); System.exit(job.waitForCompletion(true) ? 0 : 1); } }
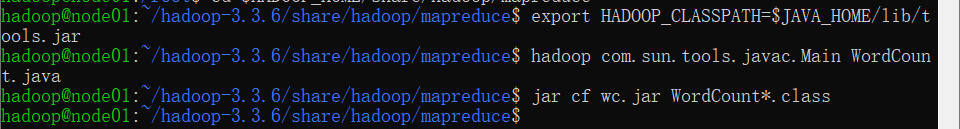
1 2 3 $ export HADOOP_CLASSPATH=$JAVA_HOME/lib/tools.jar $ hadoop com.sun.tools.javac.Main WordCount.java $ jar cf wc.jar WordCount*.class
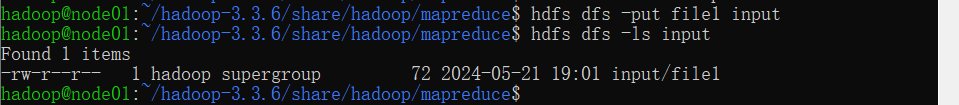
1 2 3 4 5 6 7 8 9 $ vi file1 Hello World Bye World Hello Hadoop Bye Hadoop Bye Hadoop Hello Hadoop $ hdfs dfs -rm -r input $ hdfs dfs -rm -r output $ hdfs dfs -mkdir input $ hdfs dfs -put file1 input $ hdfs dfs -ls input
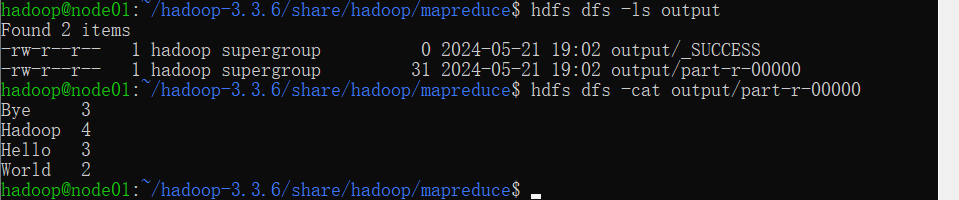
1 2 3 $ hadoop jar wc.jar WordCount /user/hadoop/input/file1 /user/hadoop/output/ $ hdfs dfs -ls output $ hdfs dfs -cat output/part-r-00000
安装scala语言支持
1 $ sudo apt update && sudo apt install scala -y
下载解压spark-3.4.2
1 2 $ wget http://bigdata.cg.lzu.edu.cn/bigdata_software/spark-3.4.2-bin-hadoop3.tgz $ tar -zxvf spark-3.4.2-bin-hadoop3.tgz
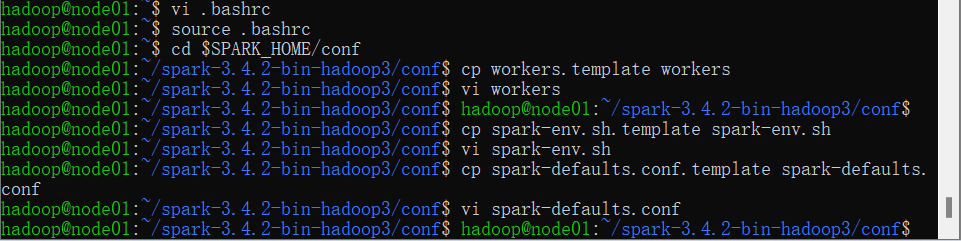
添加环境变量
#spark env config
1 2 3 4 export SPARK_HOME=~/spark-3.4.2-bin-hadoop3 export PATH=$PATH:$SPARK_HOME/bin export LD_LIBRARY_PATH=$HADOOP_HOME/lib/native/:$LD_LIBRARY_PATH $ source .bashrc
配置
1 2 $ cd $SPARK_HOME/conf $ cp workers.template workers
添加工作节点(单节点只添加本机)
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 $ vi workers node01 $ cp spark-env.sh.template spark-env.sh $ vi spark-env.sh export JAVA_HOME=/home/hadoop/jdk1.8.0_401 export HADOOP_HOME=/home/hadoop/hadoop-3.3.6 export HADOOP_CONF_DIR=/home/hadoop/hadoop-3.3.6/etc/hadoop/ export SPARK_MASTER_HOST=node01 export SPARK_PID_DIR=/home/hadoop/spark-3.4.2-bin-hadoop3/data export SPARK_LOCAL_DIR=/home/hadoop/spark-3.4.2-bin-hadoop3 export SPARK_EXECUTOR_MEMORY=512M export SPARK_WORKER_MEMORY=2G export SCALA_HOME=/usr/share/scala $ cp spark-defaults.conf.template spark-defaults.conf $ vi spark-defaults.conf spark.master spark://node01:7077
这里不需要拷贝到其他节点,因为我使用的是单机伪集群。
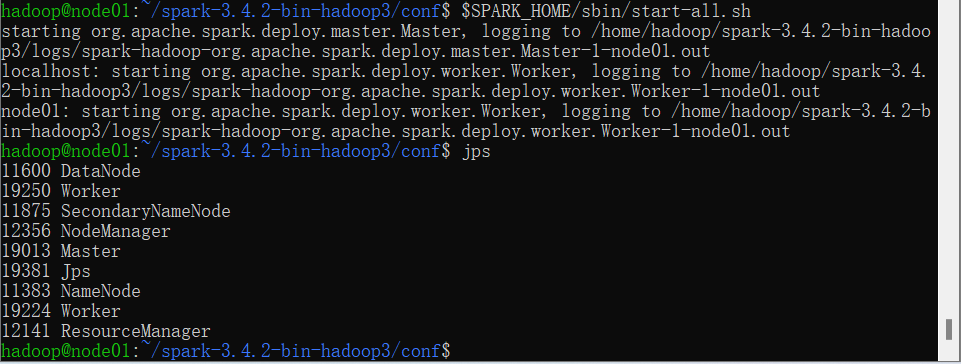
启动服务
1 2 $ $SPARK_HOME/sbin/start-all.sh $ jps
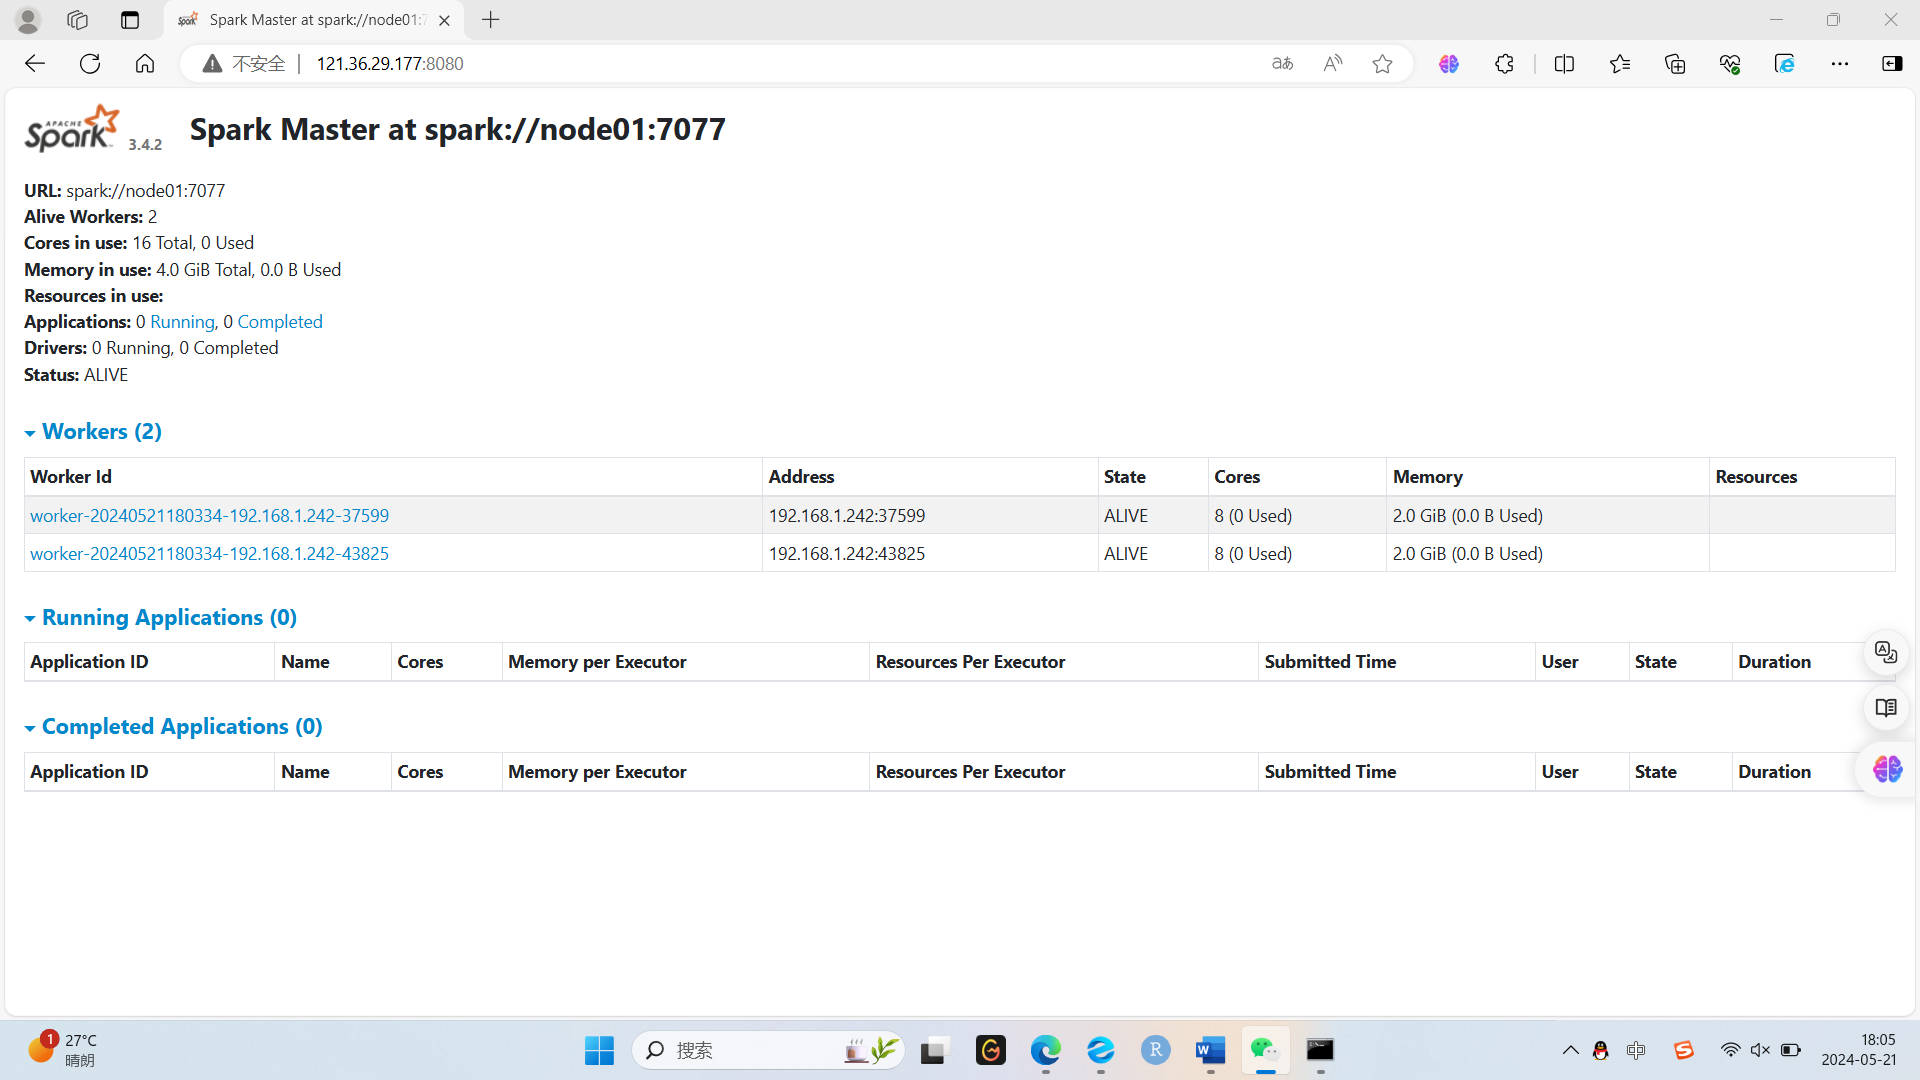
访问Web查看
http://node01:8080/
这里对应为:http://121.36.29.177:8080/
可以看到服务均成功启动。
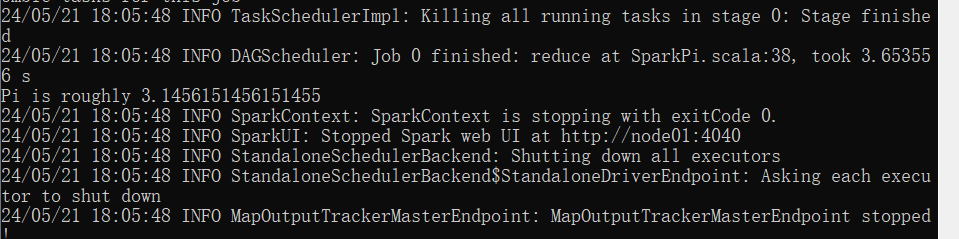
运行一个例子
1 $ $SPARK_HOME/bin/run-example SparkPi 10
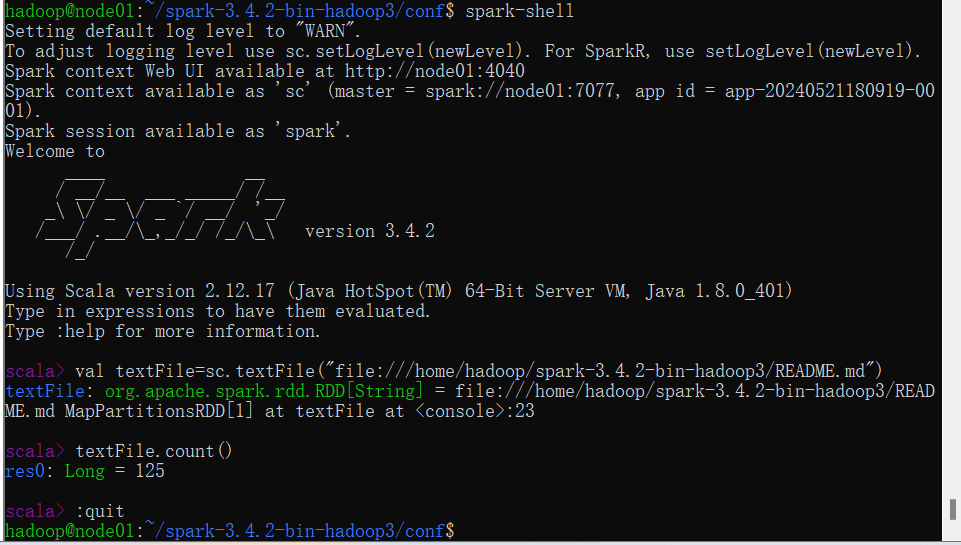
测试spark-shell
1 2 3 4 $ spark-shell scala> val textFile=sc.textFile("file:///home/hadoop/spark-3.4.2-bin-hadoop3/README.md") scala> textFile.count() scala> :quit
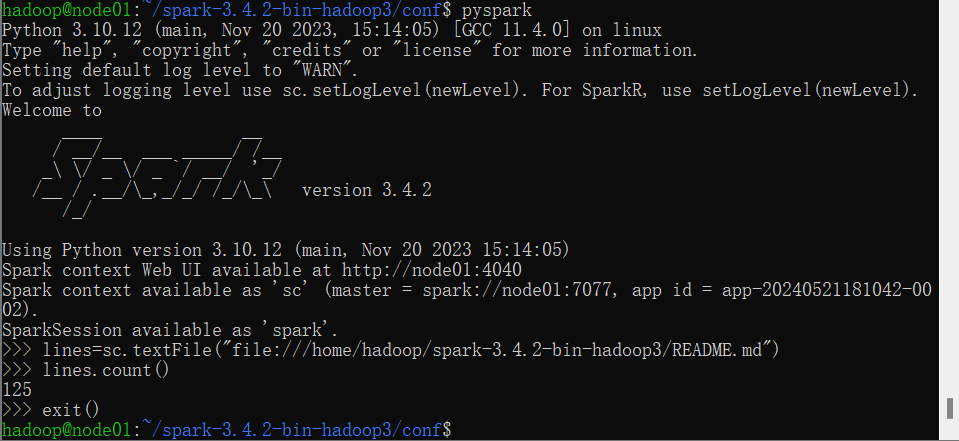
测试pyspark
1 2 3 4 5 $ pyspark >>> lines=sc.textFile("file:///home/hadoop/spark-3.4.2-bin-hadoop3/README.md") >>> lines.count() 125 >>> exit()
1 2 3 4 5 6 7 8 9 10 $ wget http://bigdata.cg.lzu.edu.cn/bigdata_software/spark_examples/try1.txt $ vi try1.py from pyspark import SparkConf,SparkContext conf = SparkConf().setMaster("spark://node01:7077").setAppName("My try1") sc = SparkContext(conf=conf) sc.setLogLevel('WARN') txt = sc.textFile("try1.txt") print(txt.count()) as_lines = txt.filter(lambda line: 'as' in line.lower()) print(as_lines.count())
将文件上传到hdfs
1 $ hdfs dfs -put try1.txt
提交任务
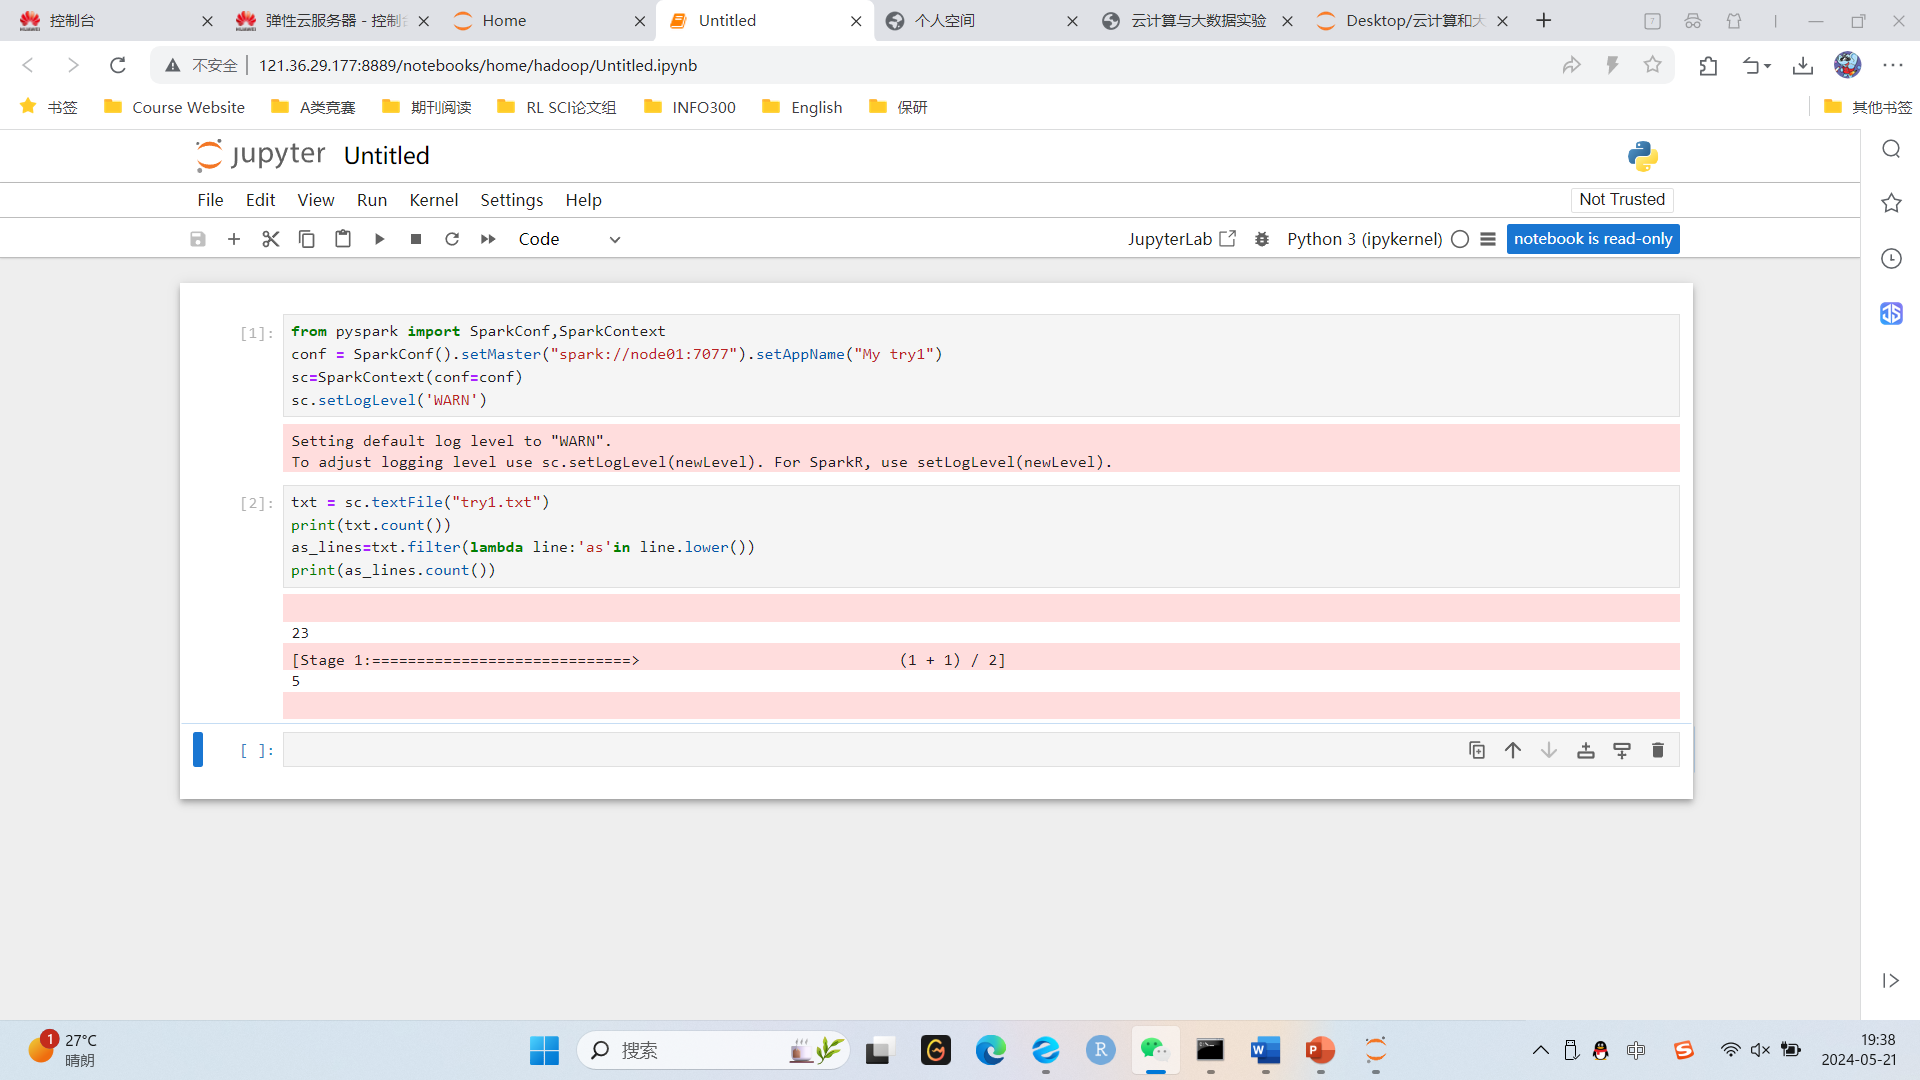
使用jupyter notebook
1
2
3
4
5
6
7
8
9
$ sudo apt update && sudo apt install pip $ sudo pip3 install jupyter $ sudo pip3 install pyspark $ vi ~/.bashrc export PYTHONPATH=$PATH:$SPARK_HOME/python export PYSPARK_PYTHON=python3 $ source ~/.bashrc $ jupyter notebook --ip=node01 $ $SPARK_HOME/sbin/stop-all.sh
至此,Hadoop、Spark、spark-submit、PySpark 和 Jupyter Notebook 的基本测试都已经跑通。
这次搭建主要覆盖了以下几个方面:
(1)Linux 用户和运行环境管理:创建独立的 hadoop 用户,配置 SSH 免密、JDK 和环境变量,保证 Hadoop/Spark 不依赖 root 用户运行。
(2)Hadoop 基础组件:安装并配置 HDFS、YARN 和 MapReduce,理解 NameNode、DataNode、ResourceManager、NodeManager 等组件的基本关系。
(3)HDFS 与 MapReduce:通过 HDFS 命令完成文件上传、下载、浏览和删除,并用 WordCount 理解 MapReduce 作业的提交和输出流程。
(4)Spark 生态:启动 Spark Standalone,使用 spark-shell、pyspark 和 spark-submit 验证交互式计算与作业提交。