分布式训练经常被介绍成一串缩写:DP、DDP、FSDP、TP、PP、EP、CP。只记缩写很难形成稳定理解,因为真正决定系统行为的不是名称,而是三个问题:切分了什么、什么时候需要恢复完整数据、恢复时使用什么通信原语。
本文从 AllReduce 出发,把集合通信、显存分片、模型并行和物理拓扑放进同一个框架。
图 1:高频 TP 通信位于单机 NVLink 域,较低频的数据并行同步跨节点进行。
分析任何并行策略时,可以先写出它的“通信签名”:
1 | (参与者,传输对象,通信原语,单次数据量,调用频率,能否与计算重叠) |
例如 DDP 的核心签名是“所有数据并行 Rank、梯度、AllReduce、约一个模型梯度大小、每训练 Step 一次并按 Bucket 拆分、可以与反向重叠”;TP 则是“同一 TP Group、层内激活或部分和、AllReduce/AllGather、与当前层 Shape 有关、每层多次、位于关键路径”。
当两个方案的缩写难以比较时,通信签名通常能直接暴露真正差异。
一、先看硬件:通信不是抽象的
同样是 GPU 之间传输数据,不同链路的性能可能相差一个数量级。
1 | GPU HBM |
实际带宽受 GPU 型号、链路代际、拓扑、NIC、交换机和通信算法影响,不能只看宣传峰值。第一步应该在目标机器执行:
1 | nvidia-smi topo -m |
然后用 nccl-tests 测量真实 AllReduce、AllGather 和 ReduceScatter 带宽。
1.1 延迟—带宽模型
一次通信可以粗略表示为:
是启动延迟, 是数据量, 是有效带宽。
- 小消息更受启动延迟影响;
- 大消息更受带宽影响;
- 高频层间通信不适合放在慢速跨机链路上;
- 低频大块通信可以通过流水和重叠摊销。
这就是为什么张量并行通常留在 NVLink 域,而数据并行更容易跨节点扩展。
二、集合通信是一组积木
假设有 个 Rank,每个 Rank 持有一份或一片张量。
2.1 Broadcast
一个 Rank 把数据复制给所有 Rank,常用于同步配置或初始状态。
2.2 AllReduce
所有 Rank 的数据先做规约,每个 Rank 最终都得到相同完整结果。DDP 使用它同步梯度。
2.3 ReduceScatter
数据先规约,再把结果切成 片,每个 Rank 只保留一片。它适合“规约后本来就只需要自己的分片”的场景。
2.4 AllGather
每个 Rank 提供一片,最终所有 Rank 都拿到完整张量。参数分片系统在计算前经常需要它临时恢复完整参数。
2.5 All-to-All
每个 Rank 给其他 Rank 发送不同数据。MoE 中 Token 需要根据 Router 结果发往不同专家,是典型 All-to-All 场景。
最重要的恒等关系是:
它既解释了 Ring AllReduce,也解释了 ZeRO/FSDP 为什么可以把规约结果直接保留为分片。
三、Ring AllReduce 为什么常用于大消息
Ring AllReduce 将 Rank 组织成环,分两个阶段:
- ReduceScatter:每轮传递一个 Chunk,并对收到的数据规约;
- AllGather:把最终 Chunk 沿环传播,让每个 Rank 恢复完整结果。
若每个 Rank 的张量大小为 Bytes,则每个 Rank 的总通信量近似为:
当 较大时接近 ,通信量不会随 GPU 数量线性爆炸。Ring 的优势是带宽利用率高,代价是通信步骤多;Tree 算法步骤更少,更适合延迟敏感的小消息或大规模节点。
例如 8 张 GPU 同步一个 2GB 梯度张量,每卡传输量约为:
若通信路径有效带宽为 350GB/s,仅带宽项理论下界约 10ms;如果跨节点有效带宽只有 40GB/s,则约 87.5ms。这里还没有计入每轮启动延迟、拓扑竞争和协议开销。这个数量级差异足以解释为什么同一并行策略在单机和多机表现完全不同。
NCCL 会结合消息大小和拓扑选择算法,手动强制 Ring 或 Tree 更适合诊断和对比,不应默认当作永久优化项。
四、DDP:每张卡保存完整模型
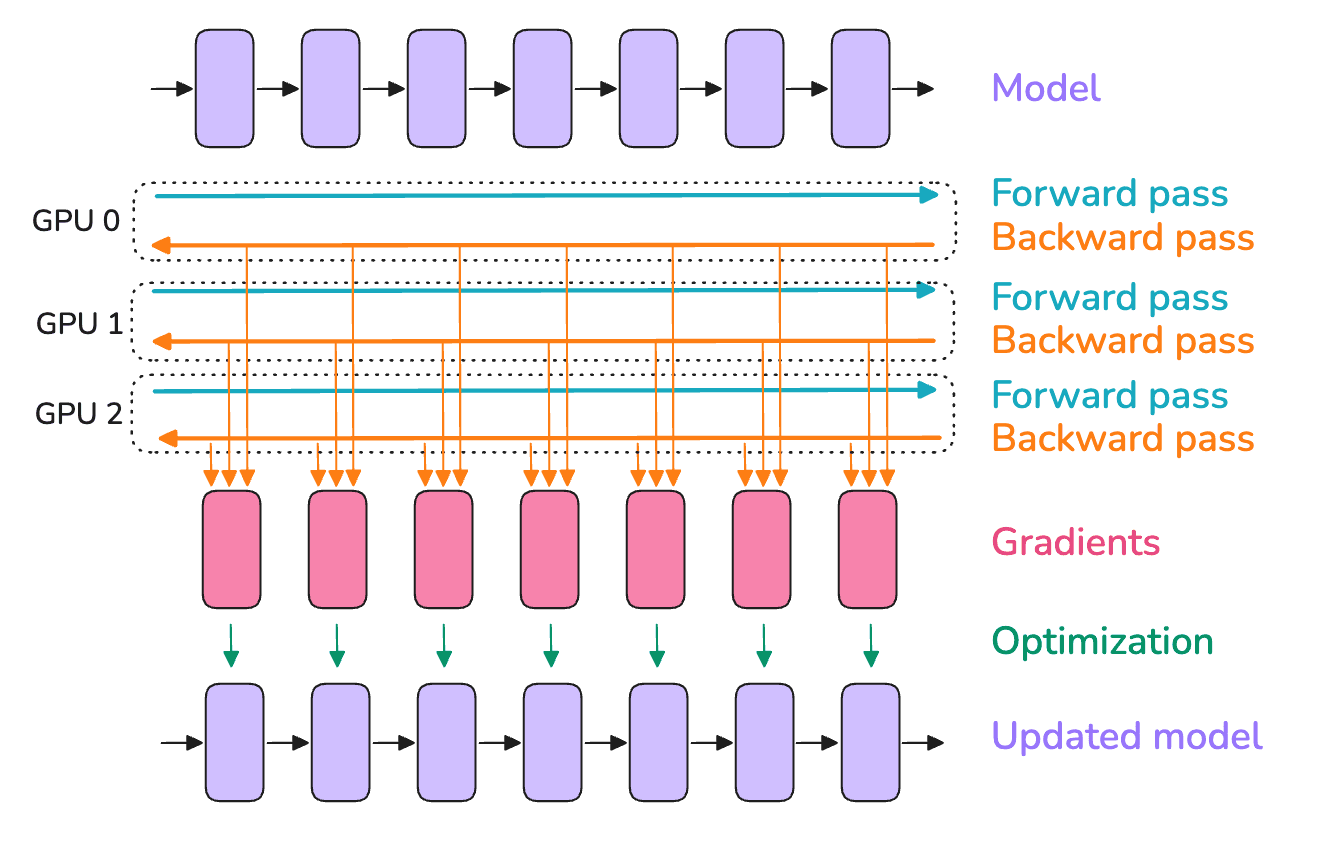
图 2:每个 Rank 保存相同模型、消费不同 Micro Batch,并在反向传播阶段同步梯度。
数据并行把 Batch 切给不同 Rank:
1 | 相同参数 |
只要初始参数相同、梯度同步正确,各 Rank 更新后的参数仍然一致。
若全局 Batch 均匀切成 份,每个 Rank 的局部平均梯度为 ,那么全局平均梯度为:
DDP 对梯度执行 AllReduce Sum,再除以 World Size,本质上恢复了单卡全局 Batch 的平均梯度。若各 Rank 有效样本数不相等,例如最后一个 Batch 或过滤后样本数不同,就不能机械地对局部平均梯度再做等权平均,需要按样本数加权。
DDP 的优点是计算路径简单,通信可以通过 Bucket 与反向传播重叠。缺点是每张卡都保存完整的参数、梯度和优化器状态。当模型本身装不下单卡时,单纯增加 DDP Rank 没有帮助。
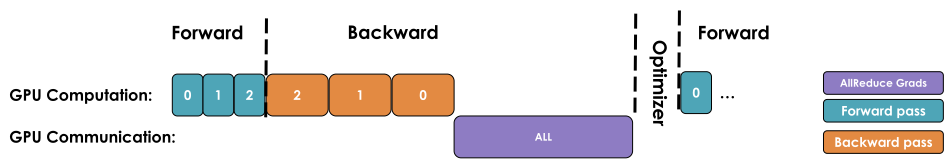
图 3:朴素实现把反向计算和通信串行化,AllReduce 阶段计算单元处于等待。
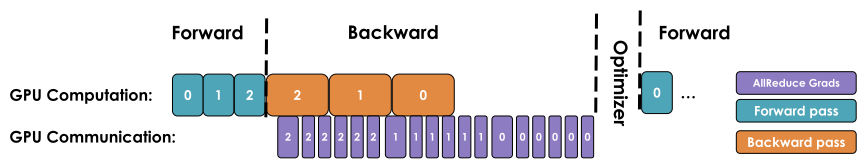
图 4:某个 Bucket 的梯度就绪后即可立即发起 AllReduce,与更早层的反向计算重叠。
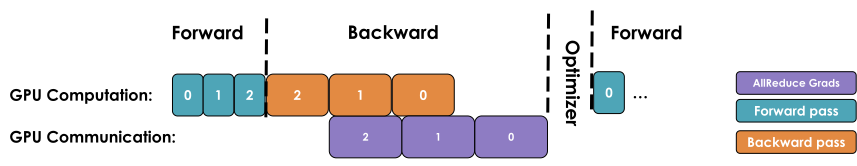
图 5:Bucket 太小会产生大量启动延迟,太大又会推迟第一次通信,调优目标是最大化计算—通信重叠。
五、FSDP/ZeRO:不再让每张卡保存所有状态
ZeRO 的核心不是一种新的数学训练方法,而是把冗余训练状态分摊到多个 Rank。
| 阶段 | 分片对象 |
|---|---|
| ZeRO-1 | 优化器状态 |
| ZeRO-2 | 优化器状态 + 梯度 |
| ZeRO-3 | 优化器状态 + 梯度 + 参数 |
FSDP Full Shard 与 ZeRO-3 的核心思想接近:
1 | 计算某个 FSDP Unit 前 |
相比 DDP,FSDP 用更多、更细粒度的通信换取显存。Unit 包得太大,峰值显存高;包得太小,集合通信次数和启动开销增加。
六、张量并行:把一次矩阵乘拆到多卡
以线性层 为例,权重可以按列或按行切分。
6.1 Column Parallel
按输出维切分 ,每张卡计算一部分输出。Q/K/V 投影和 FFN Up/Gate 常使用这种方式。
6.2 Row Parallel
按输入维切分 ,每张卡产生部分和,最后需要 AllReduce 或 ReduceScatter。Attention 输出投影和 FFN Down 常使用这种方式。
Transformer 每层都会执行多次 TP 通信,因此它对带宽和延迟极其敏感。把 TP Group 跨越慢速网络,往往会让 GPU 大量等待通信。
七、流水线并行:把层放到不同 Stage
PP 将模型层切成多个 Stage,Stage 之间传递激活和梯度,而不是频繁恢复同一矩阵的完整结果。
它更适合跨节点,但会产生流水线 Bubble。Micro Batch 越多,Bubble 比例通常越低;同时激活缓存、调度复杂度和端到端延迟也会上升。
GPipe、1F1B 和 Interleaved 1F1B 的差异,本质上是 Forward、Backward 和激活存储的调度方式不同。
八、MoE 与上下文并行
8.1 Expert Parallel
MoE 的 Router 为每个 Token 选择专家。专家分布在不同 Rank 时,需要 All-to-All:先把 Token 发给目标专家,计算完成后再发送回来。
性能风险主要来自:
- Token 路由不均衡;
- All-to-All 对网络拓扑敏感;
- 热门专家过载;
- Padding 或 Capacity 限制造成浪费和丢弃。
8.2 Context Parallel
超长序列训练可以沿 Sequence 维切分。Ring Attention、Ulysses 等方案通过不同通信方式交换 K/V 或中间结果,避免单卡保存全部长序列激活。
九、并行策略应该映射到拓扑
一个常见原则是:
1 | 高频、延迟敏感通信 → 放在单机 NVLink 域 |
因此通常:
- TP 优先放单机;
- EP 尽量放高带宽域;
- PP 可以沿节点边界切分;
- DP/FSDP 负责跨副本扩展;
- CP 根据序列长度和网络能力安排。
9.1 两机 16 卡例子
若每台机器 8 张 GPU,设置 TP=8、DP=2:
1 | TP Group 0: rank 0-7 |
TP 通信留在各自机器内,DP 梯度同步跨机。若模型层数和延迟允许,也可以使用 TP=4、PP=2、DP=2,让每台机器包含两个 TP Group,并在 Stage 间传递激活。
十、启动和排障同样属于并行设计
分布式代码中必须区分:
rank:全局进程编号;local_rank:当前节点内进程编号;world_size:总进程数;process_group:参与某类集合通信的 Rank 集合。
一卡一进程时,设备绑定通常使用 local_rank,而不是全局 rank。
遇到 Hang,可以按下面顺序排查:
- 每个 Rank 是否执行了相同顺序的集合通信;
world_size、Rank 和 Rendezvous 参数是否一致;- GPU 与
local_rank是否正确绑定; - 网卡和 IB/RoCE 配置是否一致;
- 是否有某个 Rank 在进入集合通信前异常退出;
- 开启
NCCL_DEBUG=INFO检查拓扑和连接信息; - 用
nccl-tests将网络问题与训练代码问题分离。
NCCL_P2P_DISABLE 等开关适合定位问题,不应在没有证据时长期关闭高速路径。
十一、技术 Q&A
Q1:为什么 Ring AllReduce 每卡通信量接近两倍张量大小?
ReduceScatter 阶段每卡进行 轮、每轮传输 ,通信量为 ;AllGather 阶段相同,两者相加得到 。GPU 数增大时系数趋近 2,但通信轮数和延迟项仍会增加。
Q2:FSDP 为什么用 ReduceScatter 返回梯度?
参数和优化器状态本来就是分片保存的,每个 Rank 最终只需要自己负责的梯度分片。AllReduce 会让每卡都得到完整梯度,随后又丢弃大部分,既浪费显存又多做了 AllGather;ReduceScatter 则在完成规约的同时直接把目标分片留在对应 Rank。
Q3:TP 为什么比 PP 更依赖低延迟、高带宽链路?
TP 在几乎每个 Transformer 层的线性层之间插入集合通信,频率高且直接位于关键路径;PP 主要在 Stage 边界传输激活和梯度,次数与 Stage/Micro Batch 调度相关,通信粒度更大、频率相对较低,也更容易通过流水调度重叠。因此 TP 通常限制在 NVLink 域,而 PP 更适合跨节点扩展。
Q4:如何区分集合通信 Hang 是代码问题还是网络问题?
先确认各 Rank 是否以相同顺序、相同张量形状进入同一 Collective,并检查是否有 Rank 提前异常退出;再用 NCCL_DEBUG=INFO 查看连接和拓扑。若独立 nccl-tests 在相同节点、网卡和数据规模下也失败,应优先排查驱动、IB/RoCE、端口和网络;若测试正常,问题更可能来自程序控制流或 Process Group 使用方式。
十二、系列导航
上一篇:LLM 推理引擎的内存管理与调度
下一篇:Softmax 数值稳定性与 IO-Aware Attention
十三、参考资料
集合通信与工具
- NVIDIA NCCL Documentation:NCCL API、算法和环境变量。
- NCCL Tests:测量集合通信的实际带宽和延迟。
- Bringing HPC Techniques to Deep Learning:Ring AllReduce 的直观解释。
- PyTorch Distributed:Process Group 与集合通信 API。
并行训练
- Megatron-LM:Transformer 张量并行。
- ZeRO:训练状态分片。
- PyTorch FSDP: Experiences on Scaling Fully Sharded Data Parallel:FSDP 工程设计。
- GPipe:Pipeline Parallelism 与 Micro Batch。
- DeepSpeed Ulysses:长序列并行。
- Ring Attention:沿上下文维度分布 Attention。
- AIInfraGuide:集合通信、DDP/FSDP、ZeRO、TP/PP 与多维并行的中文资料,MIT License。