Ceph 可以同时提供块存储、文件存储和对象存储,适合作为云平台和大数据平台的底层存储。这篇记录按实际操作顺序整理,从三节点集群初始化开始,逐步完成 Dashboard、MDS、RGW、RBD、iSCSI、CephFS 和 S3 访问验证。
一、目标与环境准备
这次主要围绕 Ceph 存储的安装、配置和使用展开:
• 安装 ceph
• 配置 Mon,OSD,MGR,Dashboard,MDS 和 radosgw
• 测试块存储
• 测试文件存储
• 测试对象存储
• 测试 iscsi multipath 特性
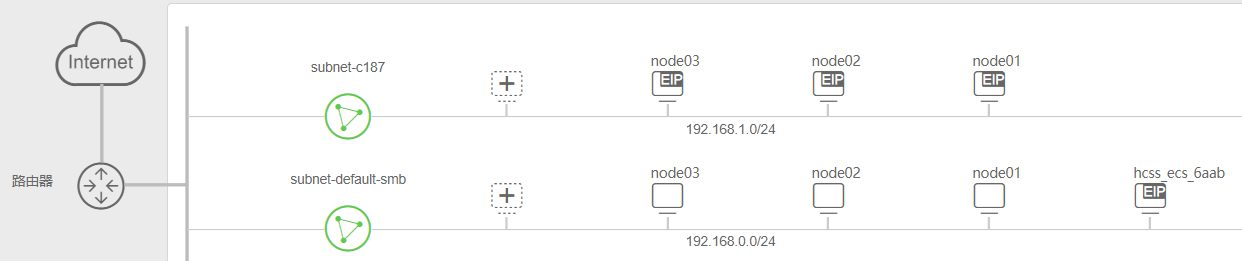
环境方面,在华为云上准备 3 台配置相同的弹性云服务器。每台服务器配置两块硬盘、两张网卡,并分配弹性公网 IP。
规格:通用计算型 | 8vCPUs | 16GiB | sn3.2xlarge.2
镜像:Ubuntu 22.04 server 64bit | 公共镜像
各服务器网段:node01 | 192.168.0.10/24 | 192.168.1.10/24
node02 | 192.168.0.11/24 | 192.168.1.11/24
node03 | 192.168.0.12/24 | 192.168.1.12/24
VPC拓扑图展示如下:
后续还额外准备了 Windows 主机和 Ubuntu 主机,用来访问图形化界面,并作为客户端测试 Ceph 的块存储、文件存储和对象存储。
二、基础环境配置
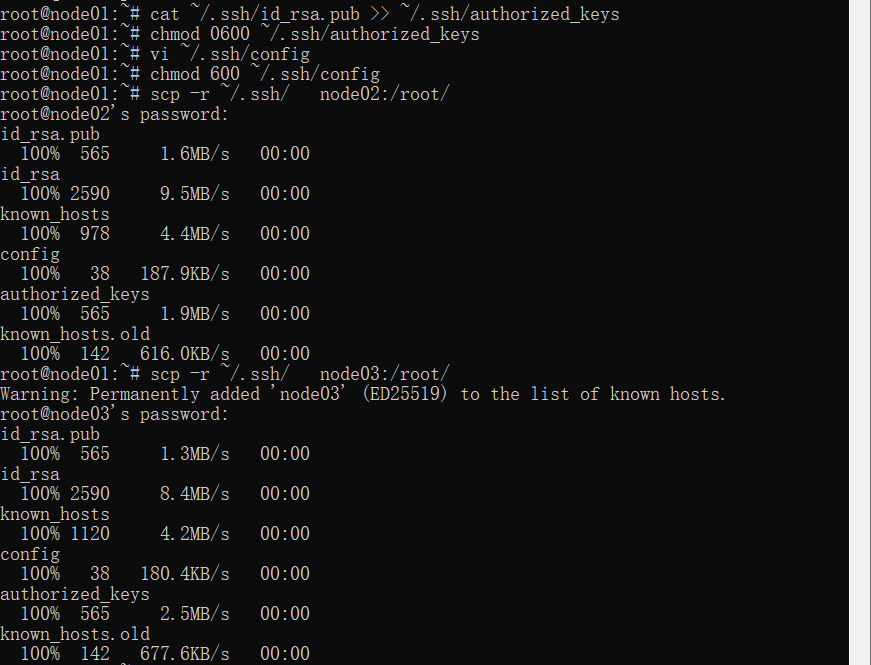
2.1 ssh配置
1
2
3
4
5
6
7
8
9
| # ssh-keygen -t rsa -P '' -f ~/.ssh/id_rsa
# cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys
# chmod 0600 ~/.ssh/authorized_keys
# vi ~/.ssh/config
Host *
StrictHostKeyChecking no
# chmod 600 ~/.ssh/config
# scp -r ~/.ssh/ ceph-02:/root/
# scp -r ~/.ssh/ ceph-03:/root/
|
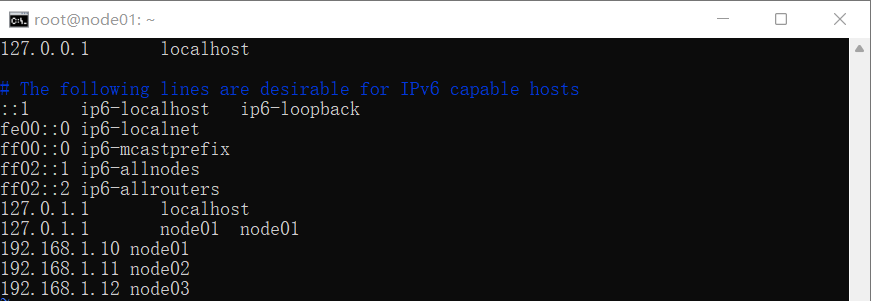
2.2 主机名解析配置
将主机名解析文件配置为图片中的内容。
2.3 系统优化
对服务器做一些常规优化,使用到前面实验的内容,这里做一些总结。
(1)关闭不必要的服务
1
| # systemctl stop cloud-config.service cloud-final.service cloud-init-local.service cloud-init.service cloud-config.target cloud-init.target
|
(2)更新系统
1
| # apt update && apt upgrade -y
|
(3)优化file-max nropen和ulimit
1
2
3
4
| # vi /etc/security/limits.conf
# vi /etc/sysctl.conf
# ulimit -Hn
# ulimit -Sn
|
(4)重启
2.4 安装Ceph包
1
2
| # apt update && apt install ceph -y
# ceph -v
|

三、Ceph集群原理
Ceph是一个统一的分布式存储系统,设计初衷是提供较好的性能、可靠性和可扩展性。一个 Ceph 存储集群至少需要一个 Ceph Monitor(监视器)、Ceph Manager(管理) 和 Ceph OSD(对象存储守护进程)。下面介绍一下这几个部分帮助完成下面的实验:
(1)Monitors
Ceph Monitor (ceph-mon) 维护集群状态的映射,包括监视器映射、管理器映射、OSD 映射、MDS 映射和 CRUSH 映射。这些映射是Ceph守护进程相互协调所需的关键集群状态。监视器还负责管理守护进程和客户端之间的身份验证。
(2)Managers
Ceph Manage守护进程 ( ceph-mgr) 负责跟踪运行时指标和Ceph集群的当前状态,包括存储利用率、当前性能指标和系统负载。
(3)Ceph OSD
一个Ceph OSD(ceph-osd)存储数据、处理数据复制、恢复、重新平衡,并通过检查其他 Ceph OSD 守护进程的心跳来向 Ceph 监视器和管理器提供一些监视信息。
(4)MDS
Ceph 元数据服务器(MDS ceph-mds) 代表Ceph 文件系统存储元数据(即 Ceph 块设备和 Ceph 对象存储不使用 MDS)。
下面是ceph的架构图:
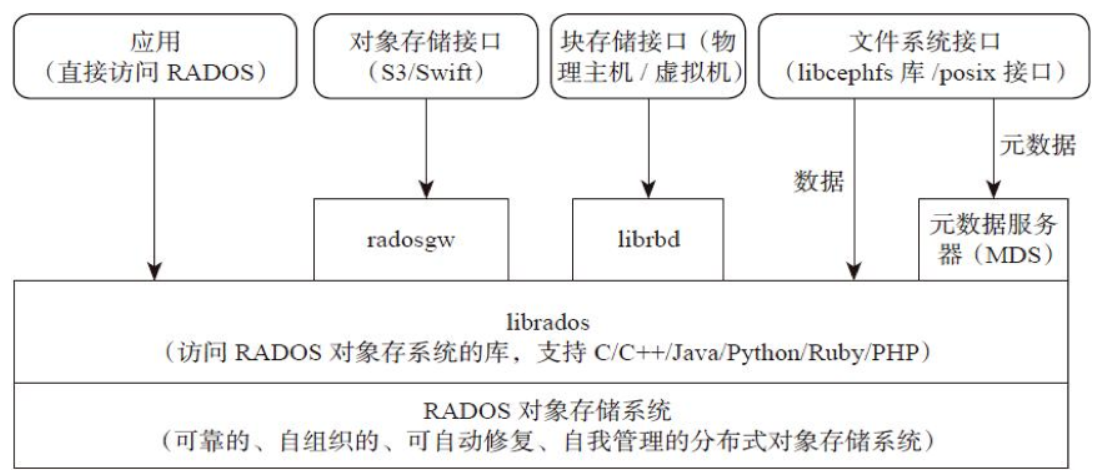
后续会用到块存储、文件存储和对象存储三类能力,先简单梳理它们在 Ceph 中对应的组件:
(1)RADOSGW(对象网关)
Ceph对象存储使用Ceph对象网关守护进程(radosgw),它是用于与Ceph存储集群交互的HTTP服务器。由于它提供了与OpenStack Swift和Amazon S3兼容的接口,因此Ceph对象网关有自己的用户管理。
(2)BRD(块存储)
块是字节序列(通常为512)。Ceph块设备是精简配置的、可调整大小的,并将数据分条存储在多个OSD上。Ceph块设备利用RADOS功能,包括快照、复制和强一致性。
(3)CEPHFS(文件存储)
Ceph文件系统或CephFS是一个符合 POSIX 的文件系统,构建在Ceph的分布式对象存储RADOS之上。文件元数据与文件数据存储在单独的 RADOS 池中,并通过可调整大小的元数据服务器集群或MDS提供服务,该集群可以扩展以支持更高吞吐量的元数据工作负载。文件系统的客户端可以直接访问 RADOS 以读取和写入文件数据块。
四、集群搭建与存储功能验证
4.1 配置 ceph 集群
(1)生成一个 uuid 作为集群的唯一标识号 fsid:
1
2
| root@ceph-01:~# uuidgen
7361c797-d1c2-4dc7-bbdb-f637c5ee0fab
|
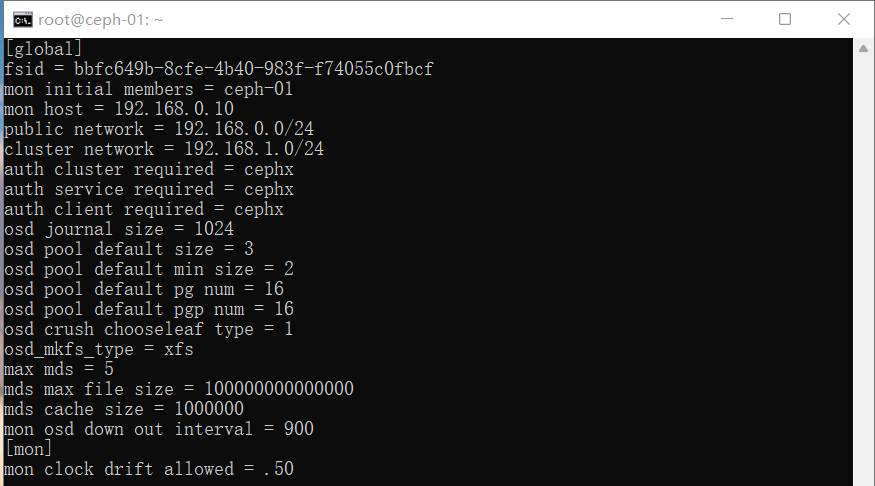
(2)在集群每个节点都安装好ceph并配置好:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
| root@ceph-01:~# vi /etc/ceph/ceph.conf
[global]
fsid = 7361c797-d1c2-4dc7-bbdb-f637c5ee0fab
mon initial members = node01
mon host = 192.168.1.10
public network = 192.168.1.0/24
cluster network = 192.168.0.0/24
auth cluster required = cephx
auth service required = cephx
auth client required = cephx
osd journal size = 1024
osd pool default size = 3
osd pool default min size = 2
osd pool default pg num = 16
osd pool default pgp num = 16
osd crush chooseleaf type = 1
osd_mkfs_type = xfs
max mds = 5
mds max file size = 100000000000000
mds cache size = 1000000
mon osd down out interval = 900
[mon]
mon clock drift allowed = .50
|
(3)对令牌环进行配置
创建令牌
1
| # ceph-authtool --create-keyring /tmp/ceph.mon.keyring --gen-key -n mon. --cap mon 'allow *'
|
创建管理令牌
1
2
3
4
| # ceph-authtool --create-keyring /etc/ceph/ceph.client.admin.keyring --gen-key -n client.admin --cap mon 'allow *' --cap osd 'allow *' --cap mds 'allow *' --cap mgr 'allow *'
# ceph-authtool --create-keyring /var/lib/ceph/bootstrap-osd/ceph.keyring --gen-key -n client.bootstrap-osd --cap mon 'profile bootstrap-osd'
# ceph-authtool /tmp/ceph.mon.keyring --import-keyring /etc/ceph/ceph.client.admin.keyring
# ceph-authtool /tmp/ceph.mon.keyring --import-keyring /var/lib/ceph/bootstrap-osd/ceph.keyring
|
创建monmaptool
1
2
3
4
| # monmaptool --create --add node01 192.168.1.10 --fsid 7361c797-d1c2-4dc7-bbdb-f637c5ee0fab /tmp/monmap
# sudo -u ceph mkdir /var/lib/ceph/mon/ceph-node01
# chown ceph.ceph /tmp/ceph.mon.keyring
# sudo -u ceph ceph-mon --mkfs -i node01 --monmap /tmp/monmap --keyring /tmp/ceph.mon.keyring
|
创建文件夹防止重新安装
1
| # sudo touch /var/lib/ceph/mon/ceph-node01/done
|
启动并查看node01状态
1
2
3
| # systemctl start ceph-mon@node01
# systemctl status ceph-mon@node01
# systemctl enable ceph-mon@node01
|
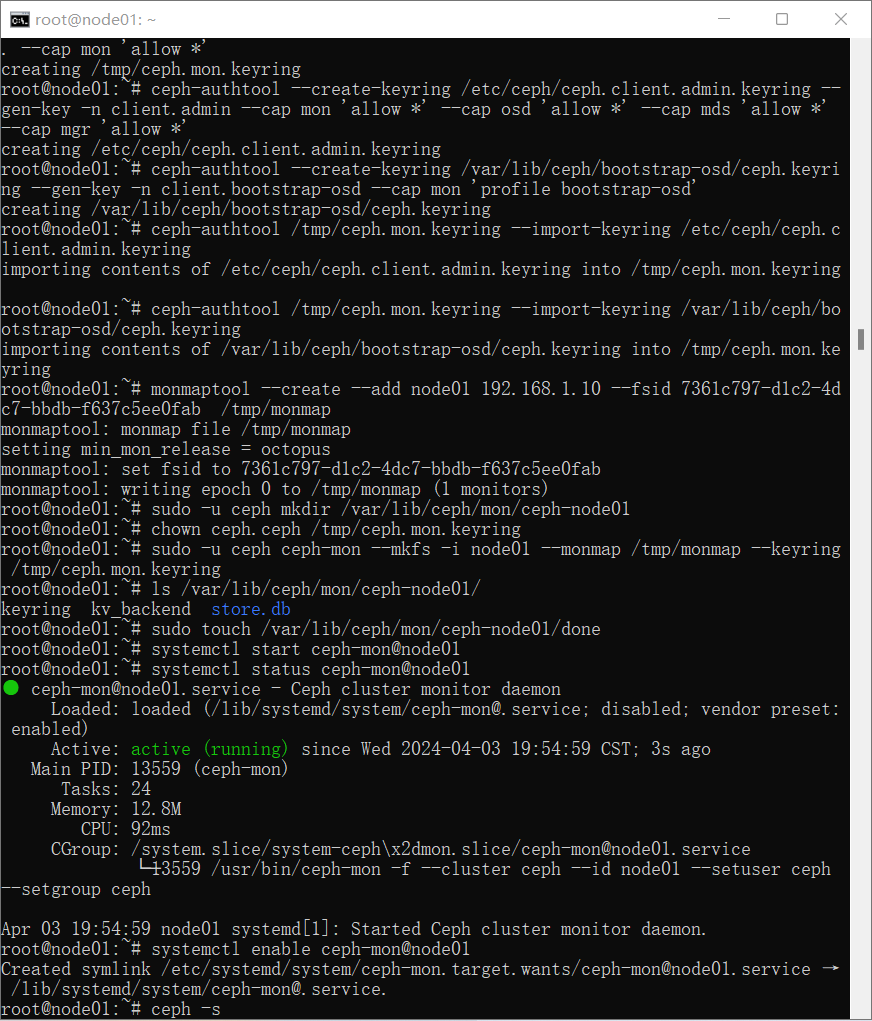
出现两条警告,输入下面的命令进行处理,警告消失。
1
2
| # ceph config set mon mon_warn_on_insecure_global_id_reclaim_allowed false
# ceph mon enable -msgr2
|
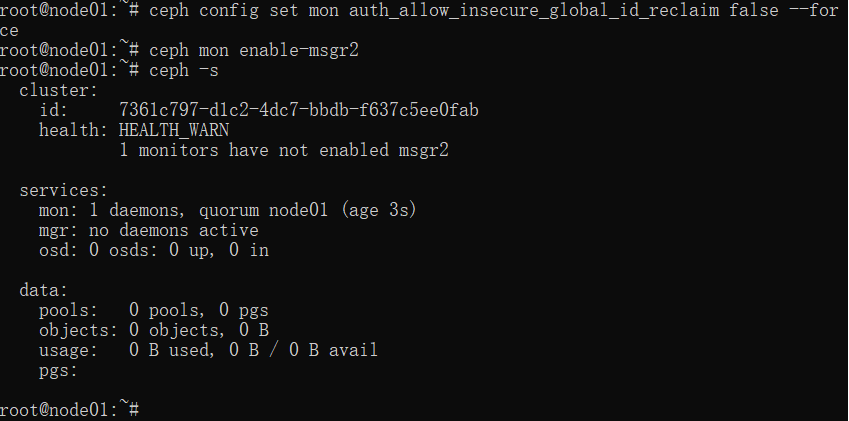
最后将node01的配置传给node02和node03:
1
2
3
4
| # scp /etc/ceph/* node02:/etc/ceph/
# scp /etc/ceph/* node03:/etc/ceph/
# scp /var/lib/ceph/bootstrap-osd/ceph.keyring node02:/var/lib/ceph/bootstrap-osd/
# scp /var/lib/ceph/bootstrap-osd/ceph.keyring node03:/var/lib/ceph/bootstrap-osd/
|
(4)为集群添加OSD
1
2
3
4
5
| # sudo ceph-volume lvm create --data /dev/vdb
# systemctl start ceph-osd@0
# systemctl status ceph-osd@0
# systemctl enable ceph-osd@0
# ceph -s
|
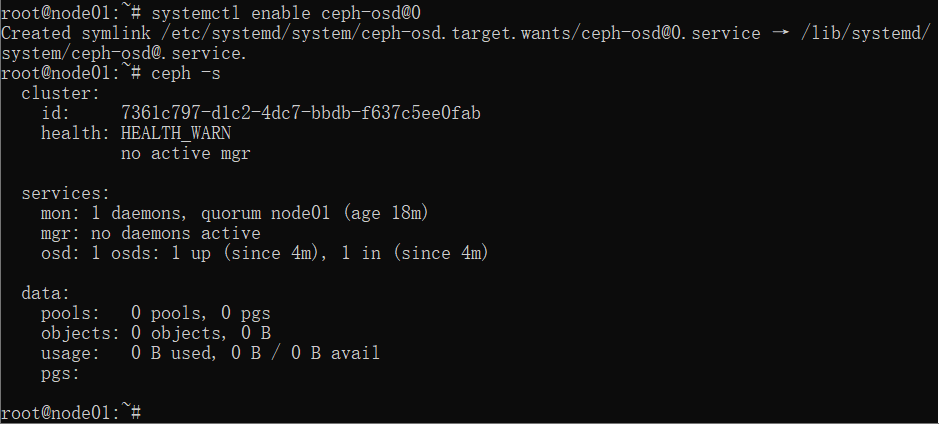
Node02和node03同理,这里不在详细写明,直接附上运行结果:
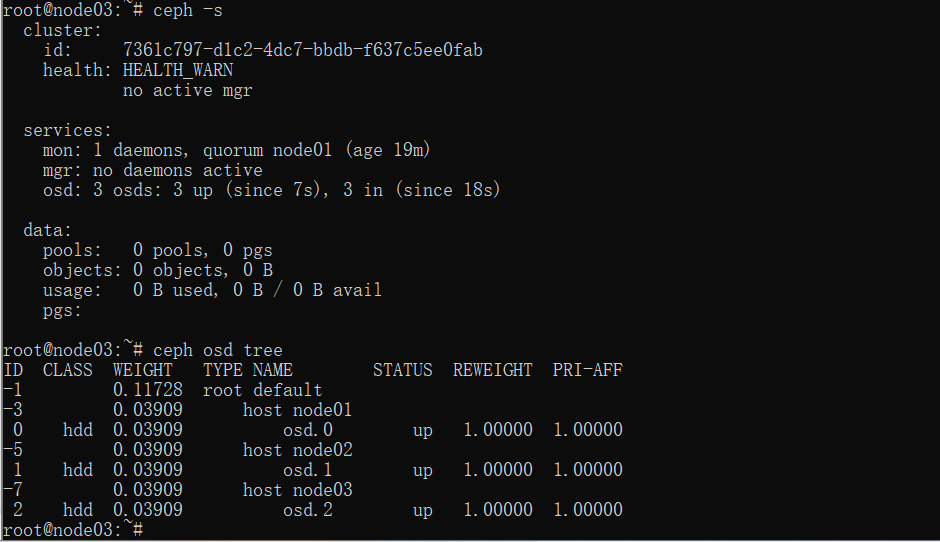
(5)发现集群健康情况中提示没有 mgr 节点,我们选择在 mon 节点上安装 mgr 节点
1
2
3
4
5
6
7
8
| # ssh node01
# ceph auth get-or-create mgr.node01 mon 'allow profile mgr' osd 'allow *' mds 'allow *'
# sudo -u ceph mkdir /var/lib/ceph/mgr/ceph-node01/
# ceph auth get mgr.node01 -o /var/lib/ceph/mgr/ceph-node01/keyring
# systemctl start ceph-mgr@node01
# systemctl status ceph-mgr@node01
# systemctl enable ceph-mgr@node01
# ceph -s
|
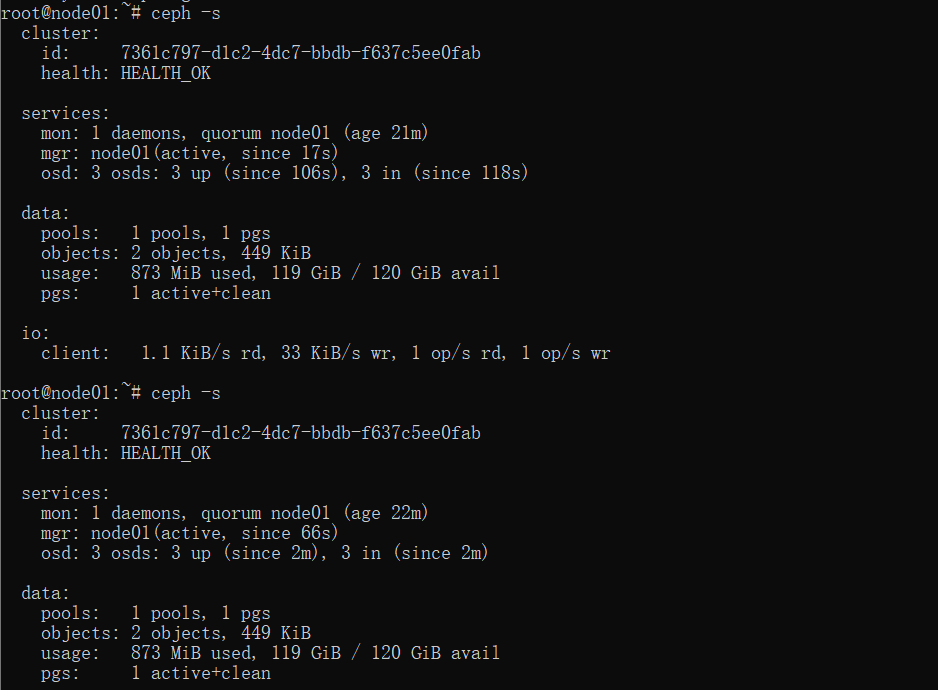
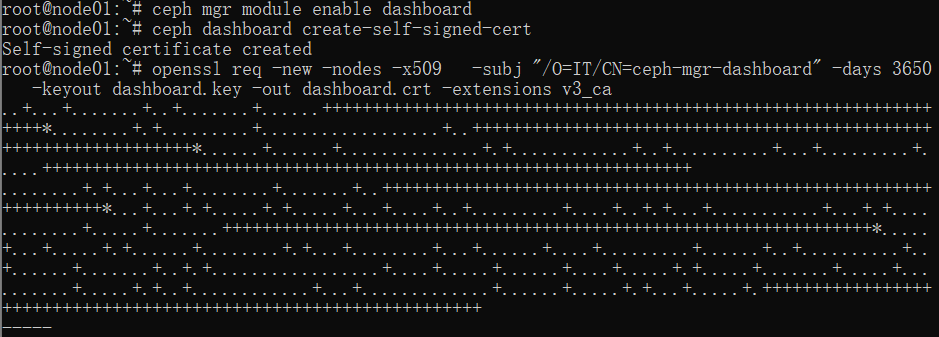
(6)为 ceph 集群安装 mgr-dashboard 软件
1
2
3
4
| # apt install ceph-mgr-dashboard -y
# ceph mgr module enable dashboard
# ceph dashboard create-self-signed-cert
# openssl req -new -nodes -x509 -subj "/O=IT/CN=ceph-mgr-dashboard" -days 3650 -keyout dashboard.key -out dashboard.crt -extensions v3_ca
|
1
2
3
4
5
6
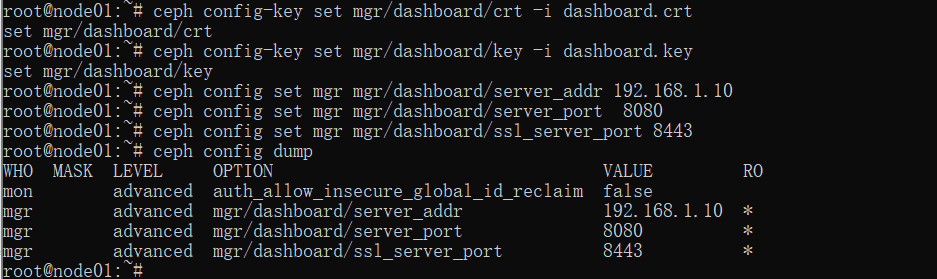
| # ceph config-key set mgr/dashboard/crt -i dashboard.crt
# ceph config-key set mgr/dashboard/key -i dashboard.key
# ceph config set mgr mgr/dashboard/server_addr 192.168.1.10
# ceph config set mgr mgr/dashboard/server_port 8080
# ceph config set mgr mgr/dashboard/ssl_server_port 8443
# ceph config dump
|
1
2
3
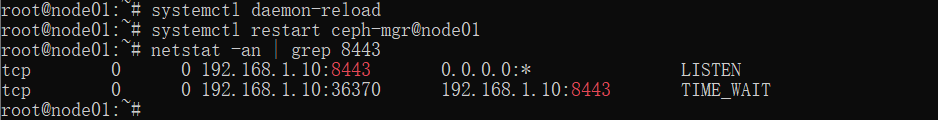
| # systemctl daemon-reload
# systemctl restart ceph-mgr@node01
# netstat -an | grep 8443
|
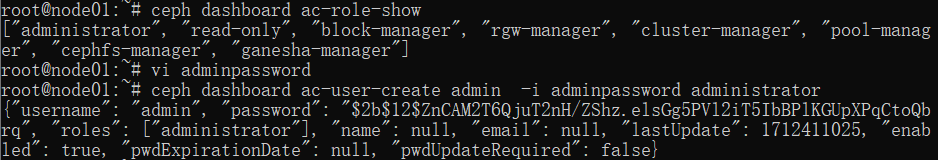
然后配置账户和密码:
1
2
3
| # ceph dashboard ac-role-show
# vi adminpassword
# ceph dashboard ac-user-create admin -i adminpassword administrator
|
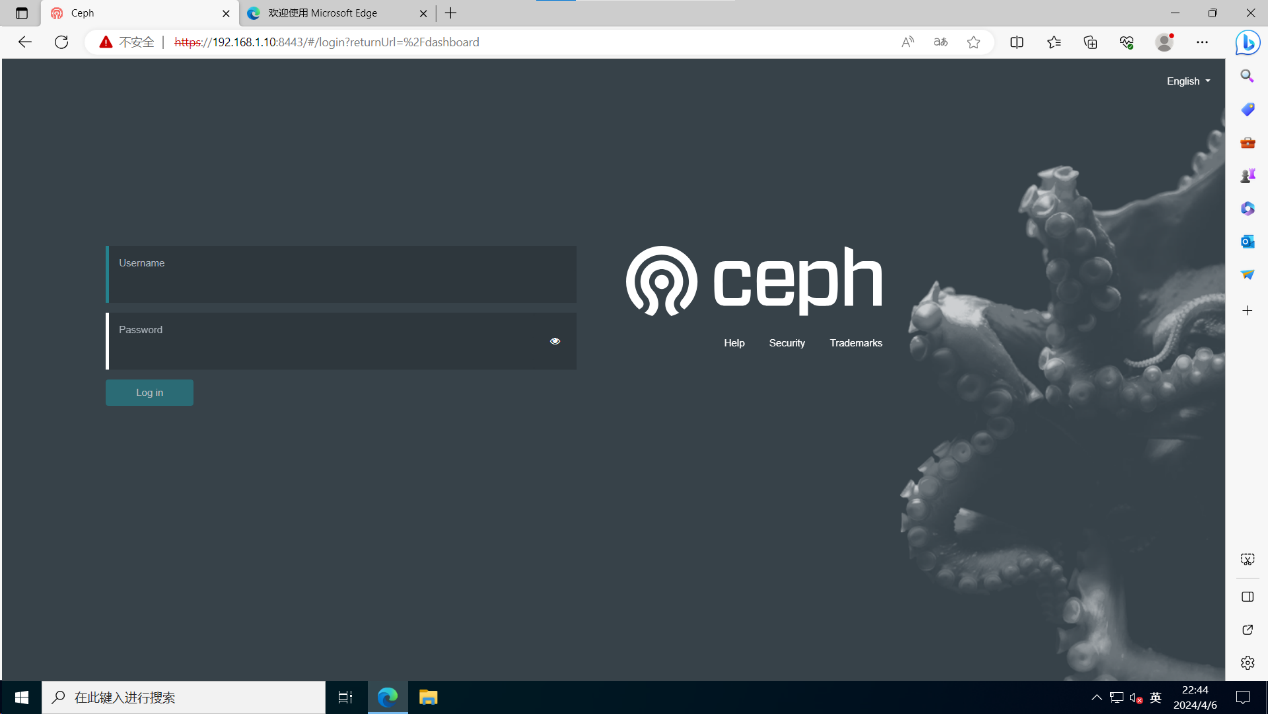
配置完成之后,访问https://192.168.1.10:8443查看 dashboard,如图所示,说明配置成功。
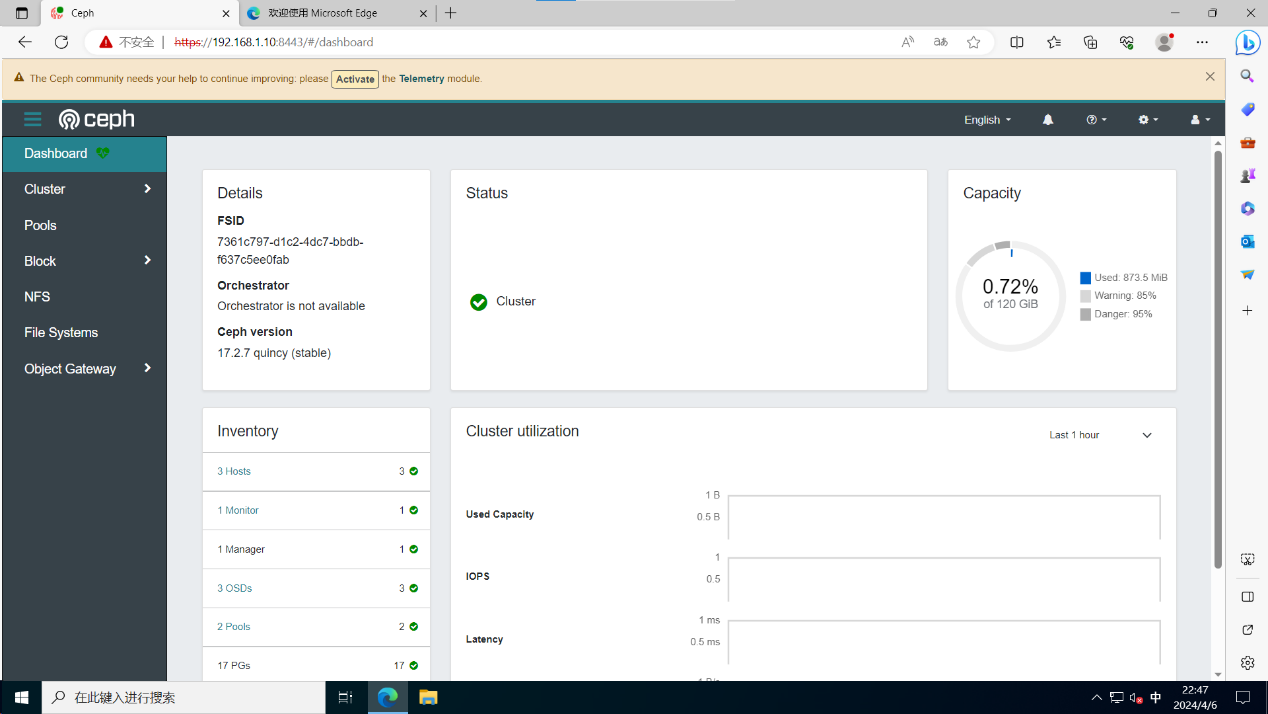
至此,集群的初始配置完成。
4.2 添加MDS和radosgw服务
创建rbd池然后初始化
1
2
3
| # ceph osd lspools
# ceph osd pool create rbd 16 16
# rbd pool init rbd
|
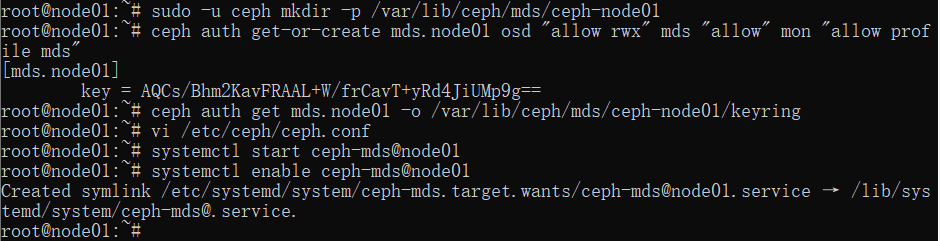
添加MDS服务
1
2
3
4
5
6
7
8
9
| # ssh node01
# sudo -u ceph mkdir -p /var/lib/ceph/mds/ceph-node01
# ceph auth get-or-create mds.node01 osd "allow rwx" mds "allow" mon "allow profile mds"
# ceph auth get mds.node01 -o /var/lib/ceph/mds/ceph-node01/keyring
# vi /etc/ceph/ceph.conf
[mds.node01]
host = node01
# systemctl start ceph-mds@node01
# systemctl enable ceph-mds@node01
|
安装radosgw并初始化
1
2
3
4
5
6
| # apt install radosgw -y
# vi /etc/ceph/ceph.conf
[client.rgw.node01]
host = node01
rgw frontends = "beast port=7480"
rgw dns name = node01
|
创建目录
1
| # sudo -u ceph mkdir -p /var/lib/ceph/radosgw/ceph-rgw.node01
|
配置令牌
1
| # ceph auth get-or-create client.rgw.node01 osd 'allow rwx' mon 'allow rw' -o /var/lib/ceph/radosgw/ceph-rgw.node01/keyring
|
创建池
1
2
3
4
5
6
7
| # ceph osd pool create .rgw.root 16 16
# ceph osd pool create default.rgw.control 16 16
# ceph osd pool create default.rgw.meta 16 16
# ceph osd pool create default.rgw.log 16 16
# ceph osd pool create default.rgw.buckets.index 16 16
# ceph osd pool create default.rgw.buckets.data 16 16
# ceph osd pool create default.rgw.buckets.non-ec 16 16
|
初始化池
1
2
3
4
5
6
7
| # ceph osd pool application enable .rgw.root rgw
# ceph osd pool application enable default.rgw.control rgw
# ceph osd pool application enable default.rgw.meta rgw
# ceph osd pool application enable default.rgw.log rgw
# ceph osd pool application enable default.rgw.buckets.index rgw
# ceph osd pool application enable default.rgw.buckets.data rgw
# ceph osd pool application enable default.rgw.buckets.non-ec rgw
|
启动服务
1
2
3
| # systemctl start ceph-radosgw@rgw.node01
# systemctl enable ceph-radosgw@rgw.node01
# ceph -s
|
创建管理用户
1
2
| # radosgw-admin user create --uid="admin" --display-name="admin user" --system
# radosgw-admin user list
|
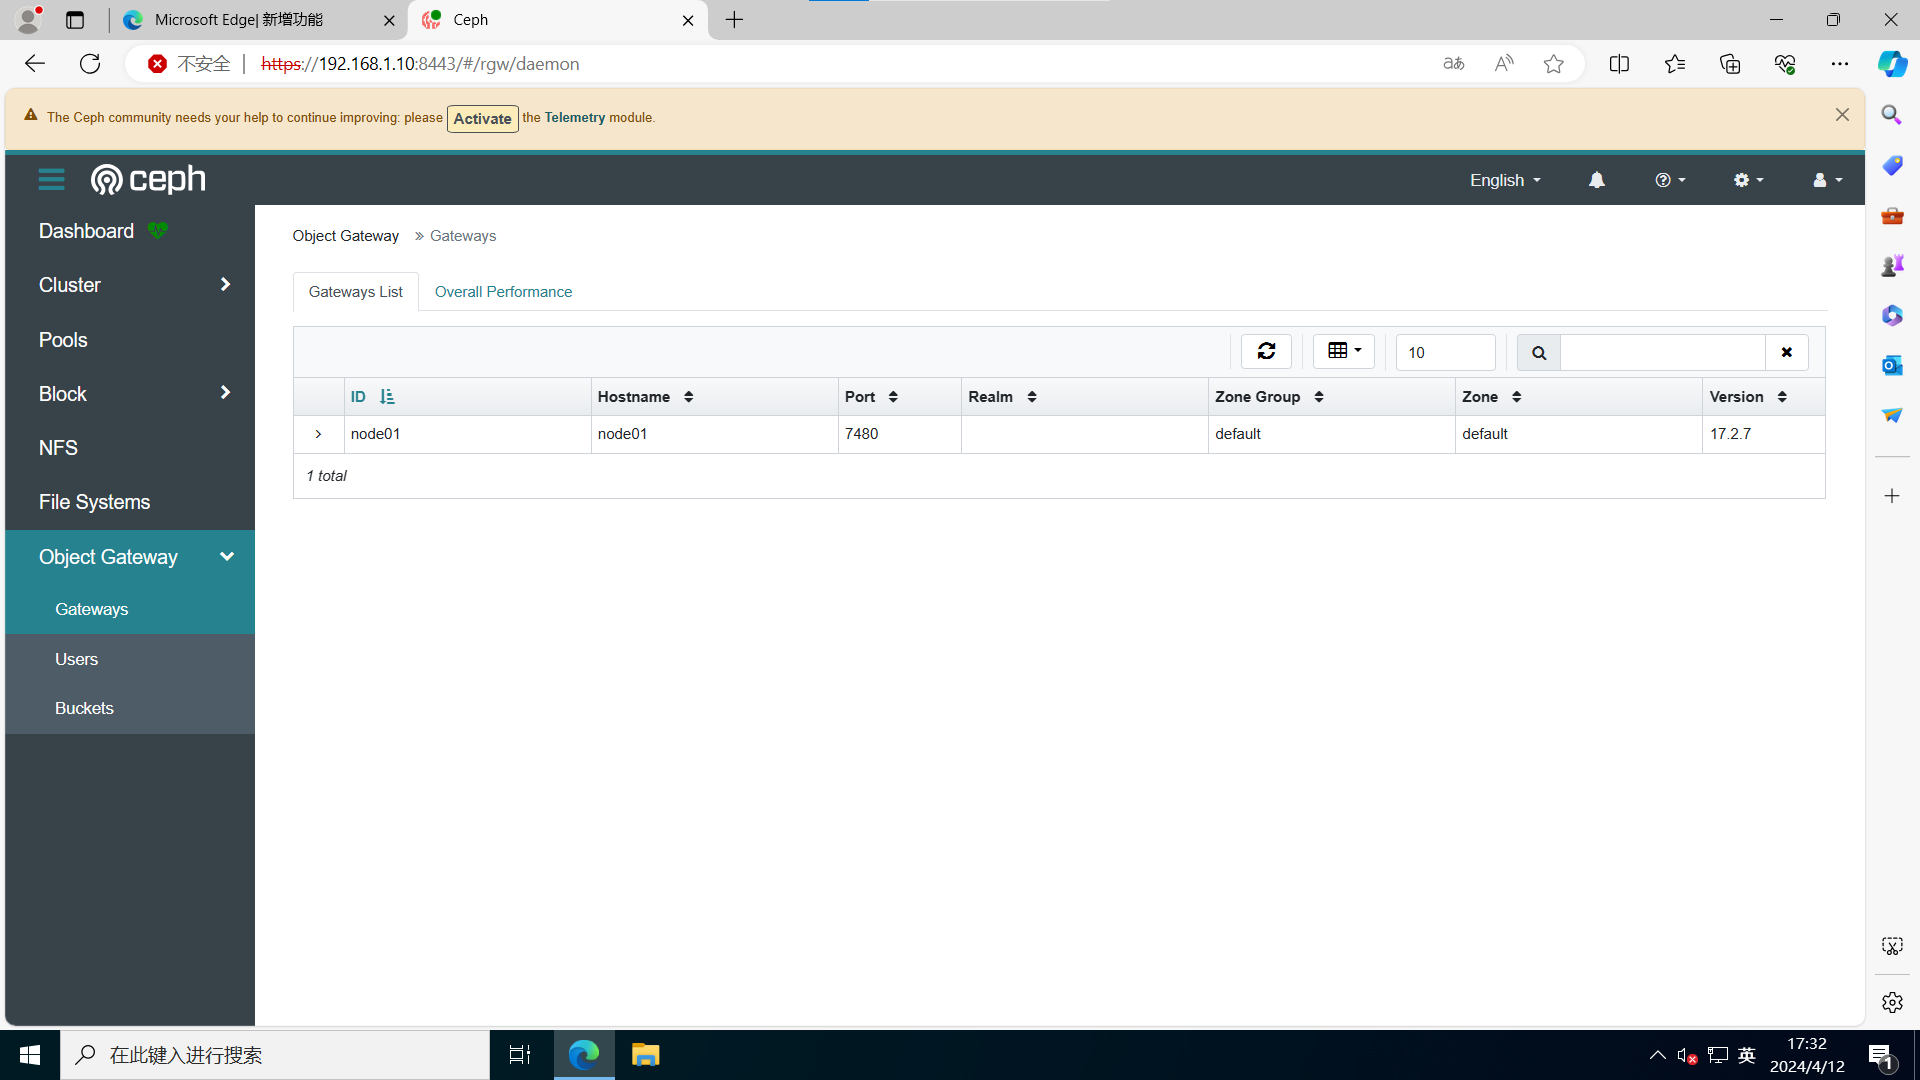
添加RGW到dashboard
1
2
3
4
5
| # vi rgw_access_key
# vi rgw_secret_key
# ceph dashboard set-rgw-api-ssl-verify false
# ceph dashboard set-rgw-api-access-key -i rgw_access_key
# ceph dashboard set-rgw-api-secret-key -i rgw_secret_key
|
安装 ceph-iscsi并配置
1
2
3
4
5
6
7
8
9
10
| # apt install ceph-iscsi
# vi /etc/ceph/iscsi-gateway.cfg
[config]
cluster_name = ceph
gateway_keyring = ceph.client.admin.keyring
api_secure = false
api_user = admin
api_password = admin
api_port = 5001
trusted_ip_list = 192.168.1.10
|
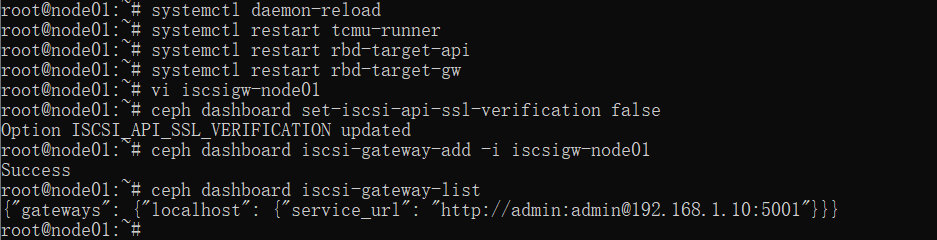
启动服务
1
2
3
4
5
6
7
8
9
10
11
12
| # systemctl enable tcmu-runner
# systemctl enable rbd-target-api
# systemctl enable rbd-target-gw
# systemctl daemon-reload
# systemctl restart tcmu-runner
# systemctl restart rbd-target-api
# systemctl restart rbd-target-gw
# vi iscsigw-node01
http://admin:admin@192.168.1.10:5001
# ceph dashboard set-iscsi-api-ssl-verification false
# ceph dashboard iscsi-gateway-add -i iscsigw-node01
# ceph dashboard iscsi-gateway-list
|
4.3 块存储的使用(包括选做部分)
前面我们已经成功安装并配置了ceph-iscsi,下面我们先看一下ceph状态以及存储池情况:
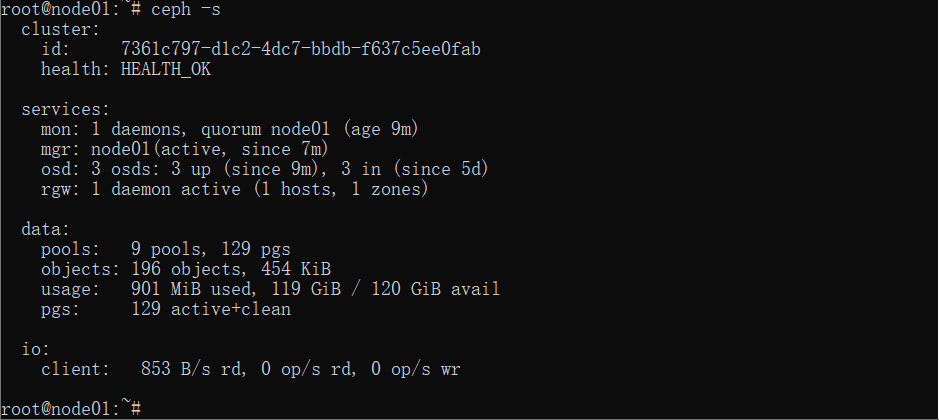
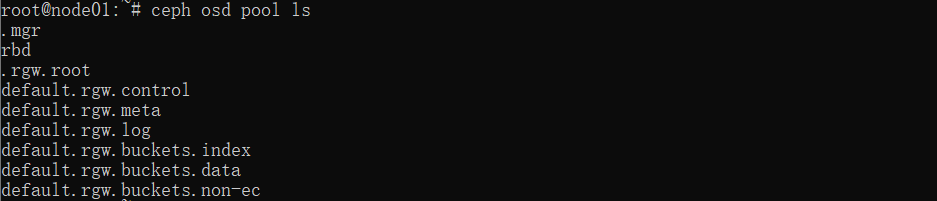
4.3.1 创建镜像
1
2
3
4
5
6
7
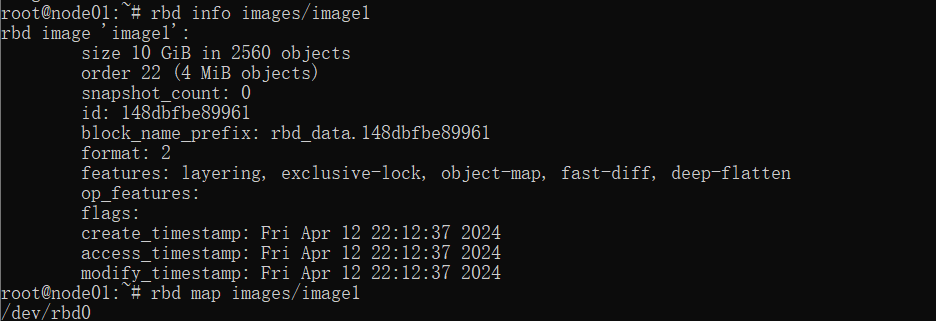
| rbd 存储池并不能直接用于块设备,而是需要事先在其中按需创建映像(image),并把映像文件作为块设备使用。
# ceph osd pool create images 16 16
# rbd pool init images
# rbd create --size 10G images/image1
# rbd ls images
# rbd info images/image1
# rbd map images/image1
|
1
2
3
4
5
6
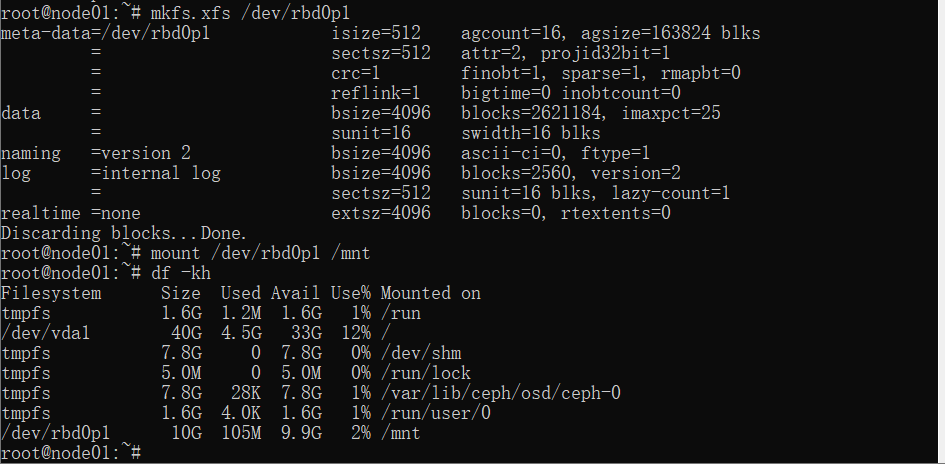
| # rbd showmapped
# fdisk /dev/rbd0
# fdisk -l /dev/rbd0
# mkfs.xfs /dev/rbd0p1
# mount /dev/rbd0p1 /mnt
# df -kh
|
此时对块设备/dev/rbd0就可以进行分区格式化文件系统挂载使用了。
断开映射
1
| # rbd device unmap /dev/rbd0
|
删除镜像
这种方法删除镜像后,镜像将不可恢复。推荐使用trash命令,这个命令删除是将镜像移动一回收站,用法为:
1
2
3
| rbd trash move <pool name>/<image name>
rbd trash list --pool <pool name>
rbd trash restore <pool name>/<id>
|
此外我们还可以调整镜像大小:
1
| rbd resize <pool name>/<image name> --size <size number>
|
4.3.2 镜像快照
Ceph全面支持快照,快照是在某个时间点上生成的只读RBD镜像副本。可以通过创建和恢复快照来保持镜像的状态以及从快照恢复原始数据。
创建一个镜像快照
1
2
| # rbd snap create images/image1@20240412
# rbd snap ls images/image1
|
保护和克隆快照
1
2
3
| # rbd snap protect images/image1@20240412
# rbd clone images/image1@20240412 images/image2
# rbd info images/image2
|
查看快照的子快照
1
| # rbd children images/image1
|

扁平化克隆,然后删除它
1
2
3
4
5
| # rbd flatten images/image2
# rbd snap unprotect images/image1@20240412
# rbd snap purge images/image1
# rbd rm images/image1
# rbd rm images/image2
|

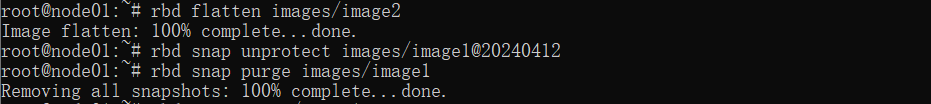
以上就是镜像与快照的实际操作与应用。
4.3.3 在客户端配置ceph
客户端使用ceph块存储需要在集群创建client账户并授权。
1
| # ceph auth get-or-create client.rbd mon 'allow r' osd 'allow rwx pool=rbd'
|
从集群导出为令牌环文件,将该文发送给客户端,客户端(这里新创建一个test客户端,内网ip为192.168.1.158)也安装好ceph。
1
2
| # ceph auth get client.rbd -o ceph.client.rbd.keyring
# scp ./ceph.client.rbd.keyring root@192.168.1.158:/etc/ceph/ceph.client.rbd.keyring
|
切换到test_node
1
2
3
4
5
6
7
8
9
10
11
12
| # sudo apt install ceph-common -y
# apt install ceph-iscsi
# vim /etc/ceph/ceph.conf
[global]
fsid = 7361c797-d1c2-4dc7-bbdb-f637c5ee0fab
mon initial members = node01,node02,node03
mon host = 192.168.1.10, 192.168.1.11, 192.168.1.12
auth cluster required = cephx
auth service required = cephx
auth client required = cephx
[client.rbd]
keyring = /etc/ceph/ceph.client.rbd.keyring
|
4.3.4 配置 iSCSI Target
使用 root 用户运行gwcli开启一个命令行窗口:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
| # 创 建 一 个iqn
/> cd /iscsi -targets/iscsi -targets > create iqn.2024-04.com.zzq:test1
# 创 建iSCSI网 关
/iscsi -targets > cd iqn.2024-04.com.zzq:test1/gateways
/iscsi -target...est1/gateways > create cephnode1 192.168.1.10
/iscsi -target...est1/gateways > create cephnode2 192.168.1.11
# 添 加 镜 像
/iscsi -target...est1/gateways > cd /disks
/disks > create pool=rbd image=disk_1 size=10G
# 为 客 户 端 创 建initiator
/disks > cd /iscsi -targets/iqn.2024-04.com.zzq:test1/hosts/
iscsi -target...t:test1/hosts > create iqn.2024-04.com.zzq:client
# 为 客 户 端 创 建 硬 盘
/iscsi -target...om.zzq:client > disk add rbd/disk_1
# 设 置 密 码
/iscsi -target...om.zzq:client > auth username=username@zzq password=password@zzq
|
使用 apt 安装 open-iscsi 和 multipath-tools
1
2
3
4
5
6
7
| # apt install open-iscsi multipath-tools
# vi /etc/iscsi/initiatorname.iscsi
InitiatorName=iqn.2024-04.com.zzq:client
# vi /etc/iscsi/iscsid.conf
node.session.auth.authmethod = CHAP
node.session.auth.username = username@zzq
node.session.auth.password = password@zzq
|
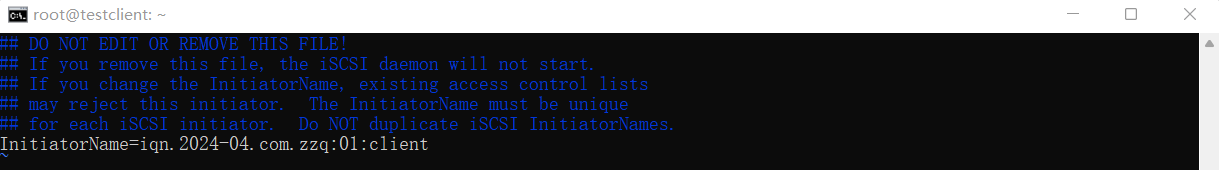
重启服务加载新的配置
1
| systemctl restart iscsid open-iscsi
|
配置 MultiPath:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
| vi /etc/multipath.conf
defaults {
user_friendly_names yes
find_multipaths yes
}
devices {
device {
vendor "LIO-ORG"
product "TCMU device"
hardware_handler "1 alua"
path_grouping_policy "failover"
path_selector "queue -length 0"
failback 60
path_checker tur
prio alua
prio_args exclusive_pref_bit
8fast_io_fail_tmo 25
no_path_retry queue
}
}
# 修改完成后重启服务加载新的配置文件
systemctl restart multipathd
|
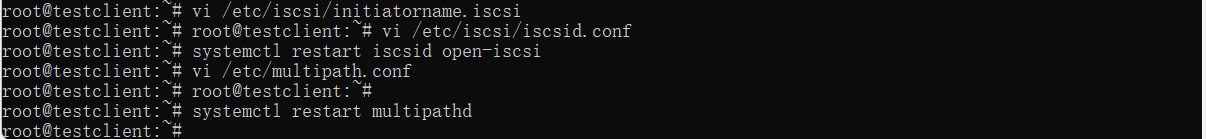
4.3.5 测试块存储
配置完成之后,可以直接使用客户端连接 ceph 提供的块存储服务。
1
| # iscsiadm -m discovery -t st -p 192.168.1.10
|
登 录
1
2
| # iscsiadm -m node --login
# multipath -ll
|
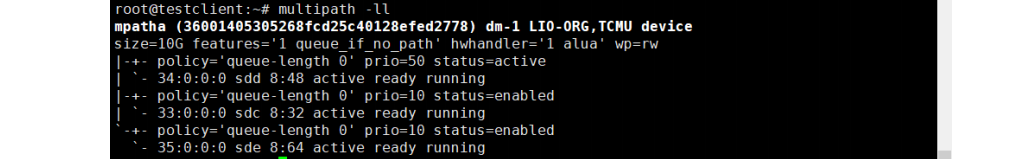
挂载情况和multipath 情况正常,块存储测试成功。
4.4 文件存储的使用
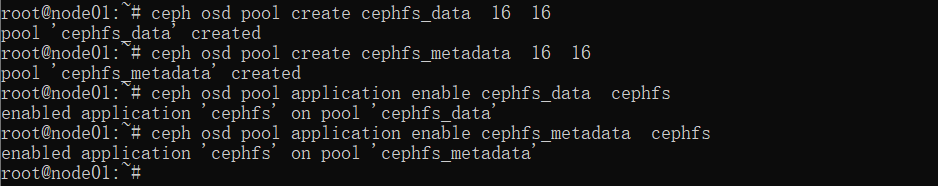
前面我们已经在服务器端成功添加了MDS服务(3.2节中),下面为文件存储创建其所需的存储池。一个存储data数据,一个存储meta数据。
1
2
3
4
| # ceph osd pool create cephfs_data 16 16
# ceph osd pool create cephfs_metadata 16 16
# ceph osd pool application enable cephfs_data cephfs
# ceph osd pool application enable cephfs_metadata cephfs
|
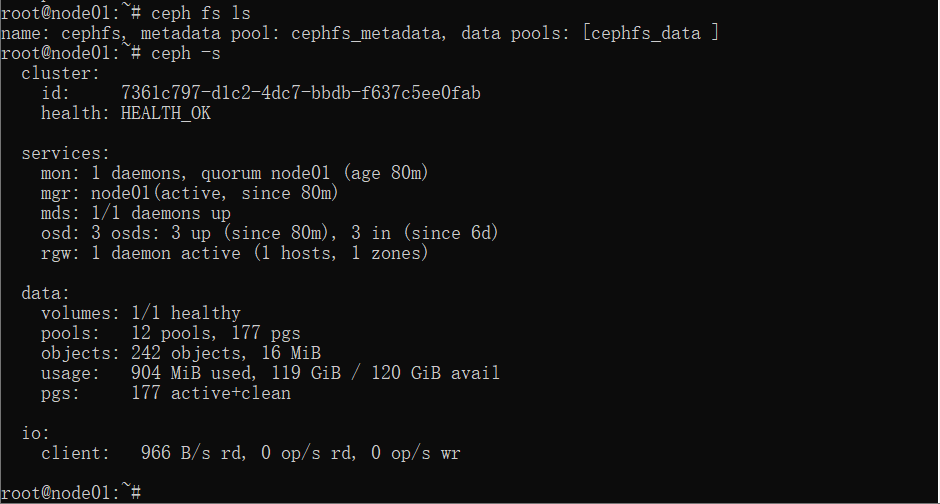
创建文件系统
1
2
3
4
| # ceph fs new cephfs cephfs_metadata cephfs_data
# ceph osd pool set cephfs_data bulk true
# ceph fs ls
# ceph -s
|
挂载cephfs
1
2
| # mkdir /mnt/cephfs
# mount -t ceph 192.168.1.158:6789:/ /mnt/cephfs -o name=admin,fs=cephfs
|
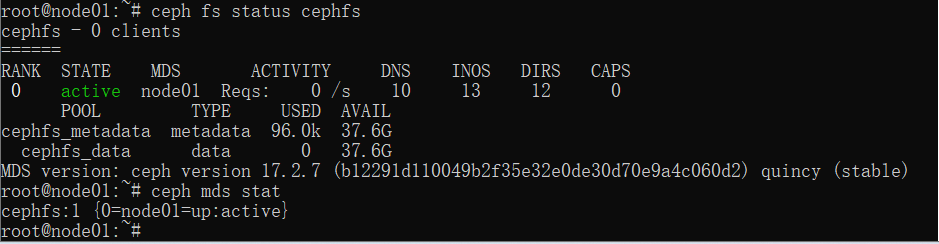
查看情况
1
2
3
| ceph fs ls
ceph fs status cephfs
ceph mds stat
|
创建cephfs用户,并允许这个用户访问cephfs池:
1
| # ceph fs authorize cephfs client.cephfs / rw
|
导出client.cephfs令牌环,客户端使用该凭证访问cephfs文件共享系统
1
| # ceph auth get-or-create client.cephfs -o /etc/ceph/client.cephfs.keyring
|
文件系统测试完成。
4.5 对象存储
4.5.1 GUI图形工具的使用
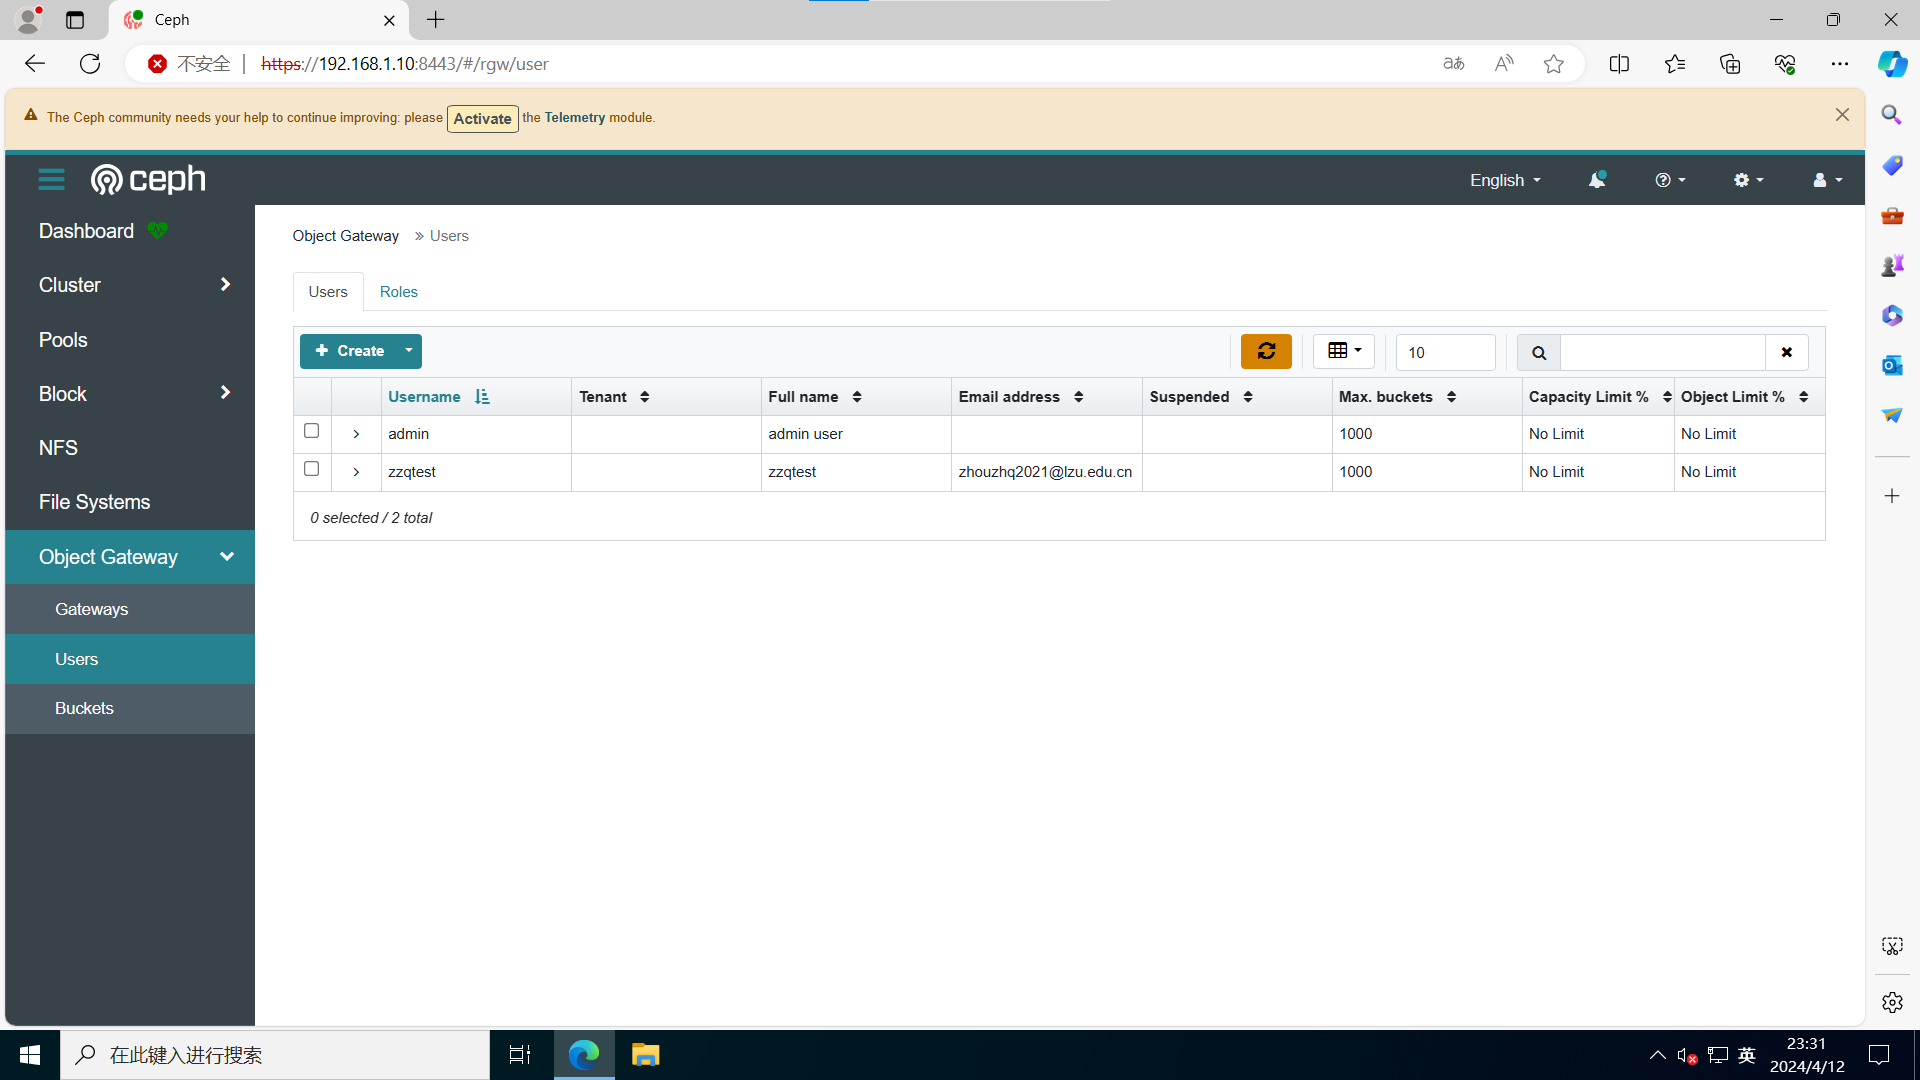
前面我们已经在ceph中创建了管理用户并且把RGW添加到dashboard中(3.2节),下面我们在ceph的GUI界面中创建另一个用户zzqtest,后期会使用“CloudBerry Explorer for Amazon S3”软件访问该用户。
首先登陆ceph管理页面,在users中创建一个zzqtest用户:
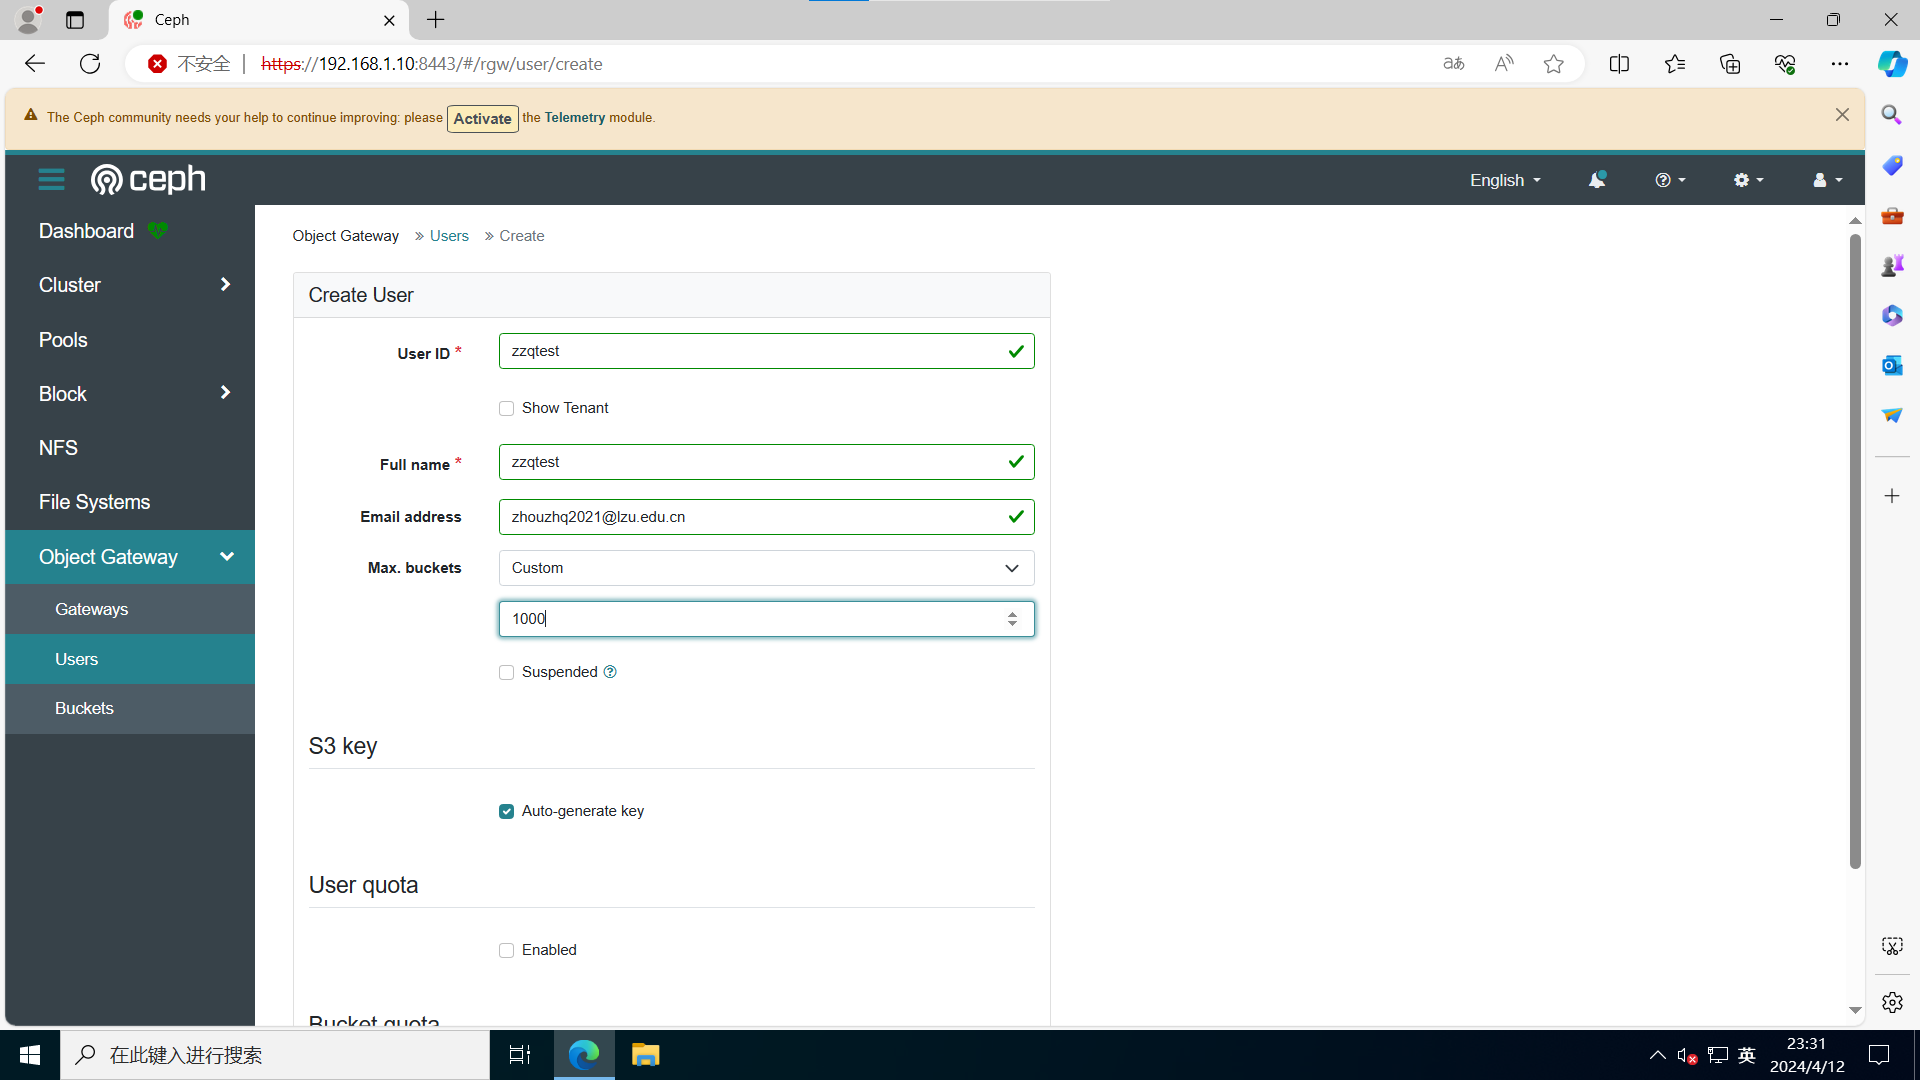
创建成功:
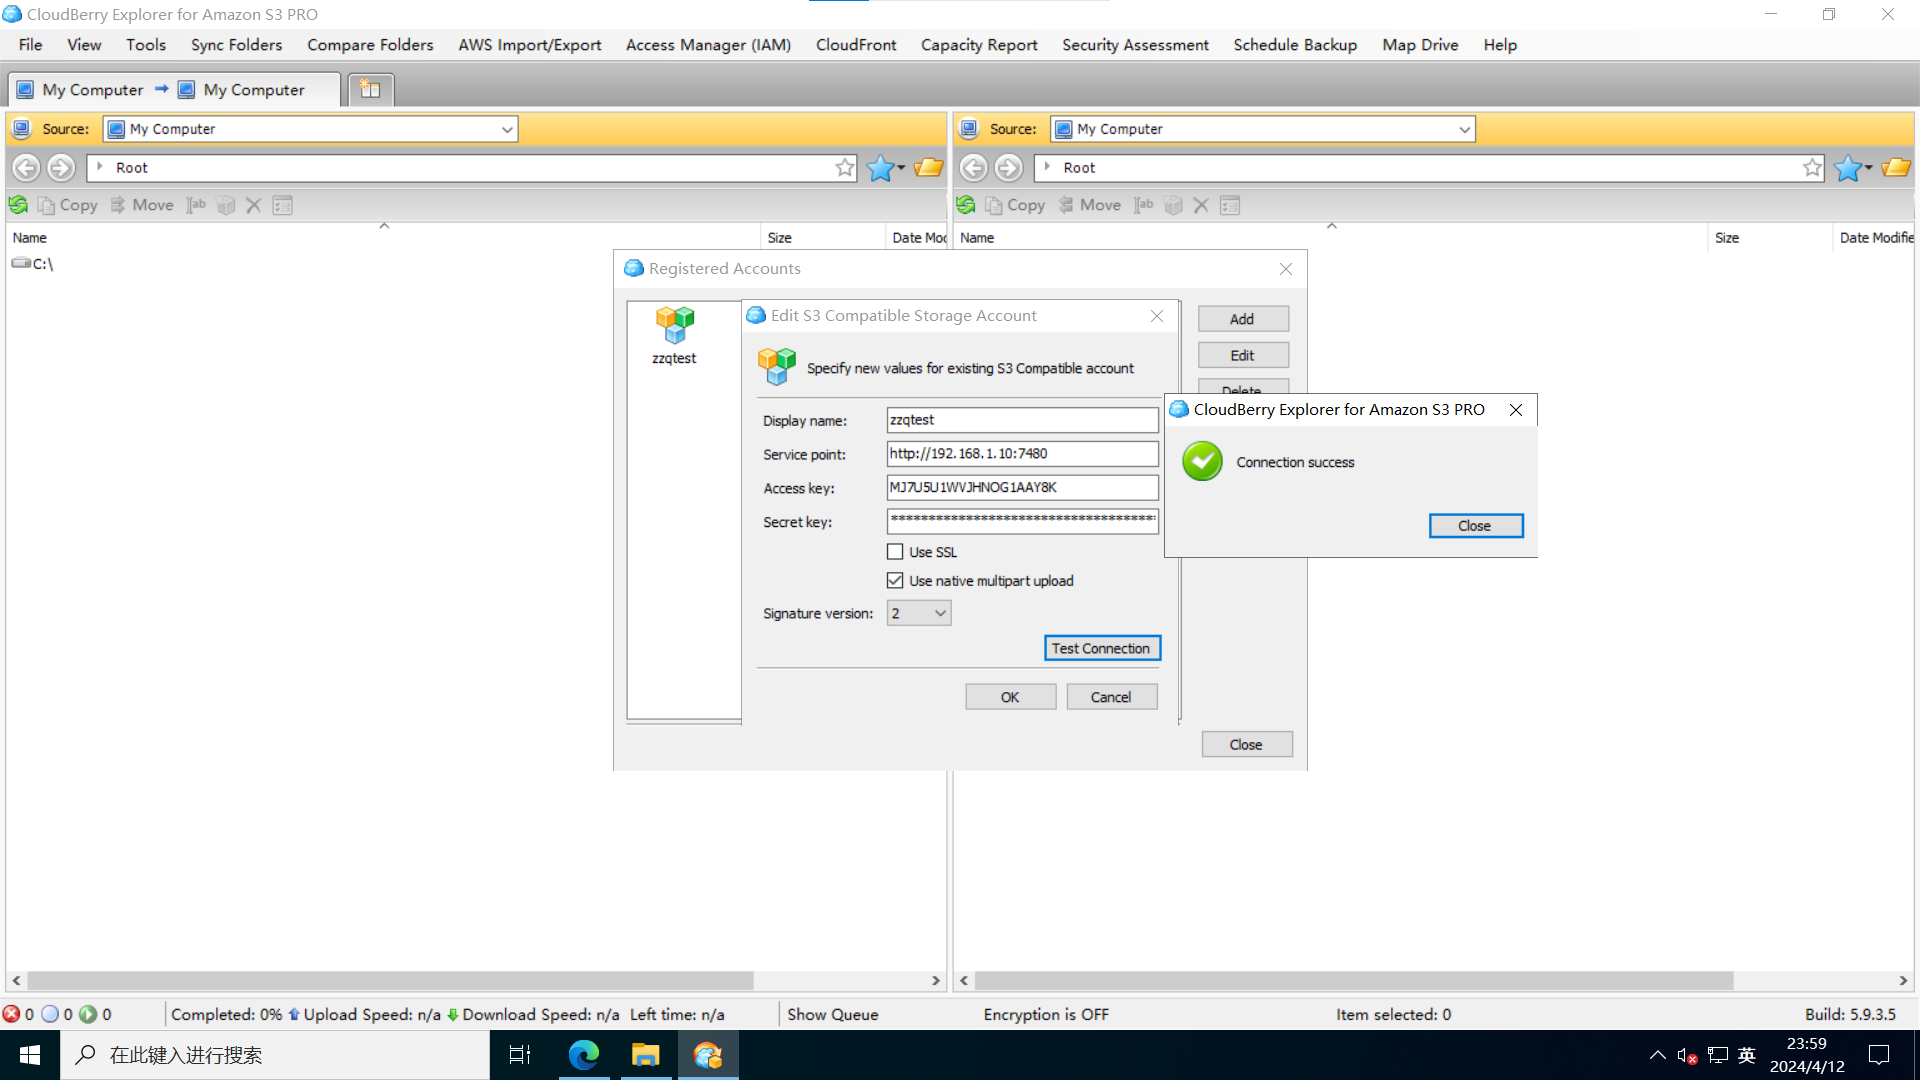
使用“CloudBerry Explorer for Amazon S3”软件访问该用户,这台主机与云服务器主机在同一子网,因此输入https://192.168.1.10:7480即可访问,两个秘钥是之前创建用户时给出的秘钥,这里直接复制粘贴过来即可。成功连接:
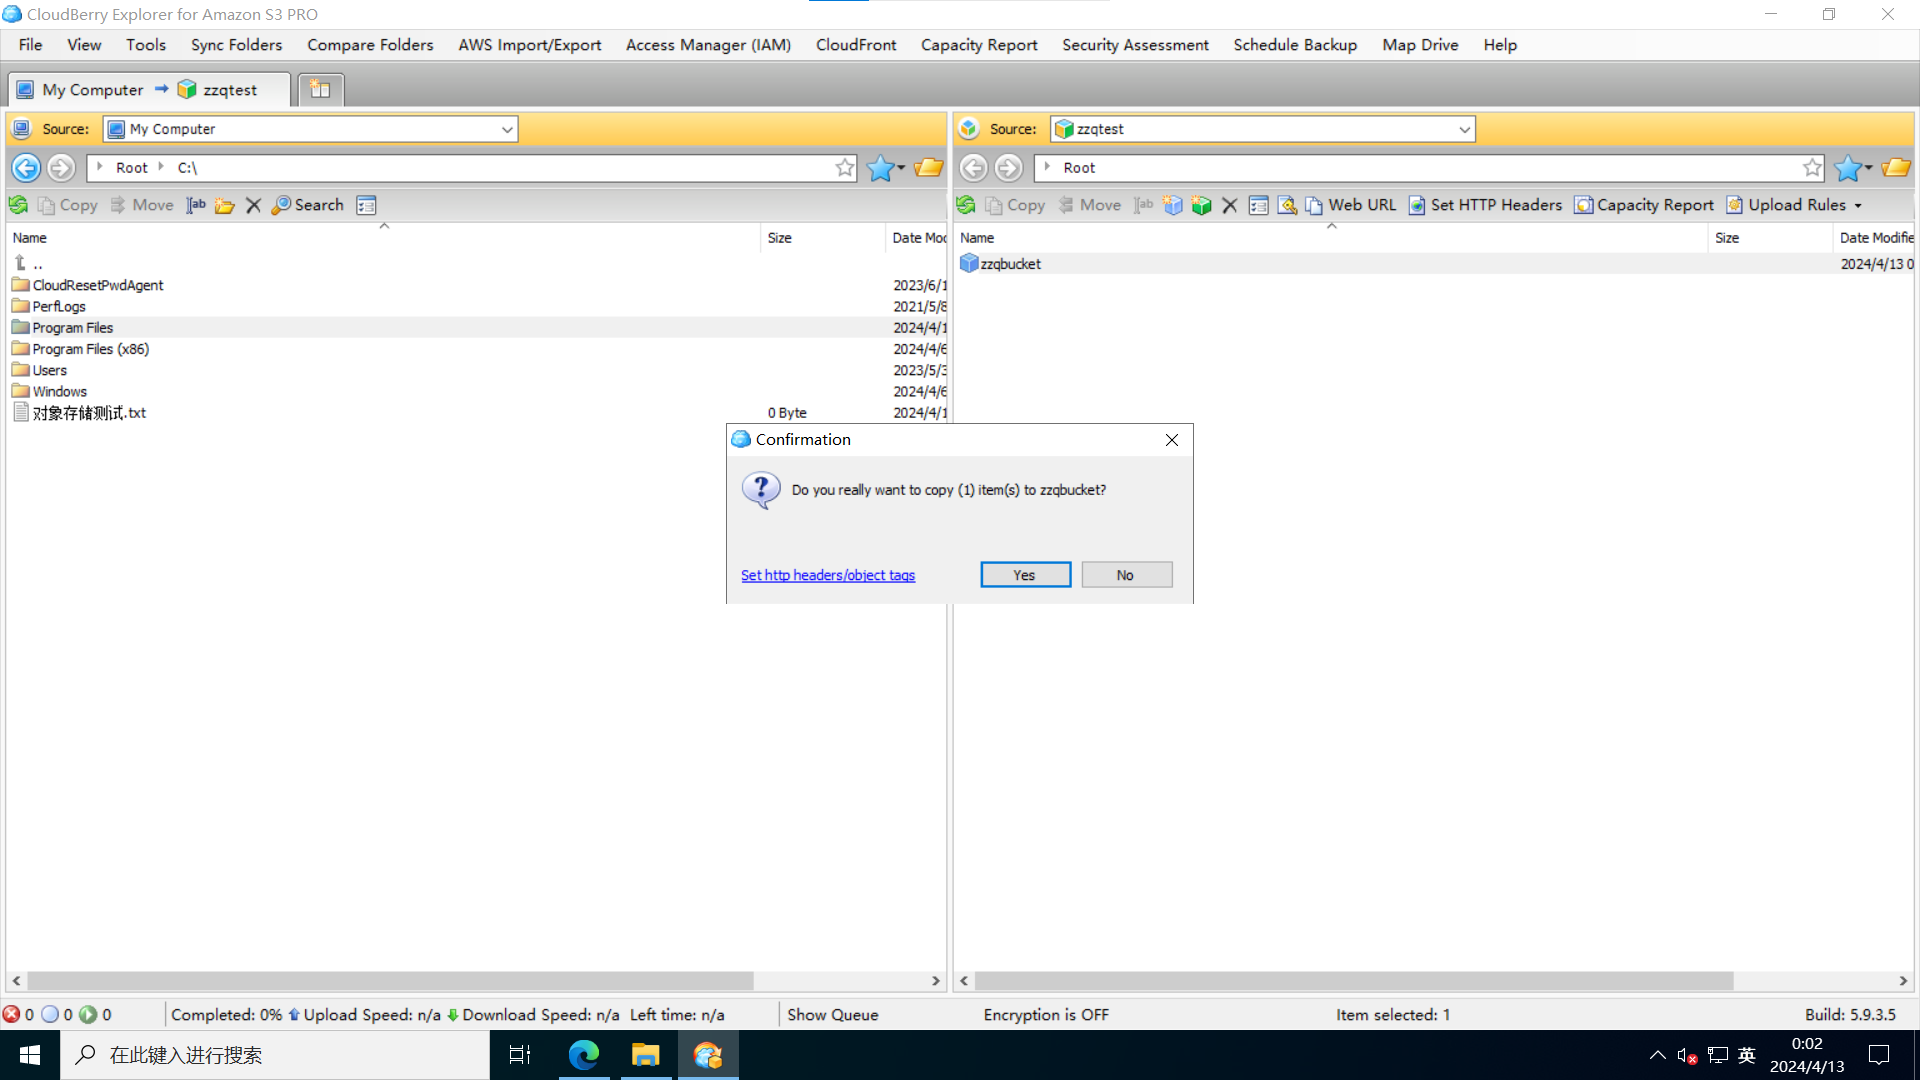
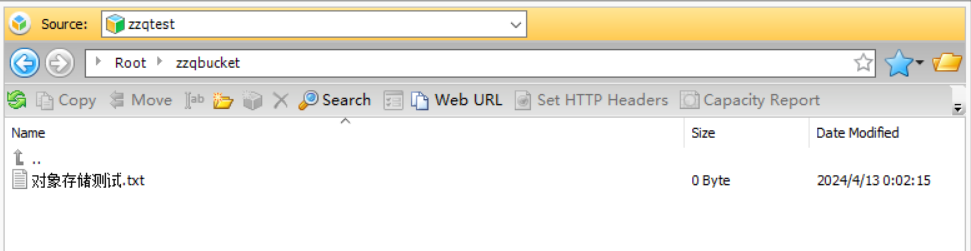
然后我在主机内新建了一个txt文件并在zzqtest下创建一个桶zzqbucket,用来测试对象存储,下面我将该txt文件传至ceph中,操作成功:
4.5.2 s3cmd命令行操作
首先我们先安装s3cmd,然后进行配置:
1
2
3
4
5
6
7
8
9
| # apt update && apt install s3cmd
# vi ~/.s3cfg
[default]
access_key = MJ7U5U1WVJHNOG1AAY8K
secret_key = 0gAjF6s8RFnr1plYEkf0lJC2TBvDuRbsECfHMmL4
host_base = 192.168.1.10:7480
host_bucket = 192.168.1.10:7480/%(bucket)
cloudfront_host = 192.168.1.10:7480
use_https = False
|
下面我在云服务器中进行s3cmd命令练习,以下是操作内容:
(1)列举所有buckets:s3cmd ls

(2)查看某个bucket中的内容:s3cmd ls s3://bucketname

(3)查看bucket包括内容: s3cmd la

(4)创建一个新的bucket:s3cmd mb s3://newbucket

(5)删除空bucket:s3cmd rb s3://newbucket

(6)上传一个txt文件到bucket:
1
| s3cmd put zzqnew.txt s3://zzqbucket
|

(7)从bucket下载文件:s3cmd get s3://zzqbucket/对象存储测试.txt
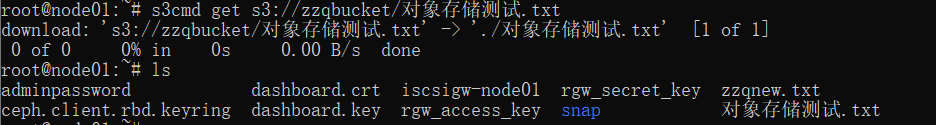
(8)删除bucket中的文件:s3cmd rm s3://zzqbucket/对象存储测试.txt

(9)查看bucket已使用空间:s3cmd du -H s3://zzqbucket

(10)获取bucket的信息:s3cmd info s3://zzqbucket
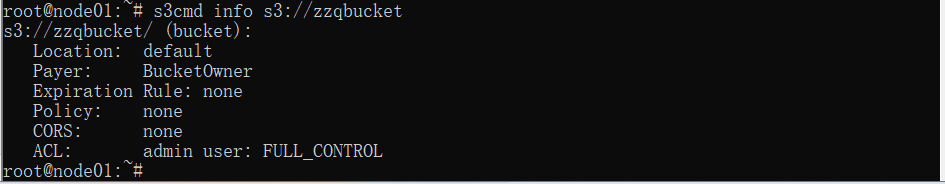
(11)移动bucket中文件:s3cmd mv s3://zzqbucket/zzqnew.txt s3://zzqbucket2/zzqnew2.txt
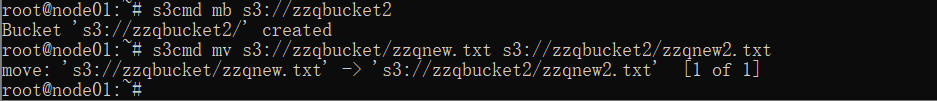
(12)本地目录下文件同步bucket:s3cmd sync s3://zzqbucket
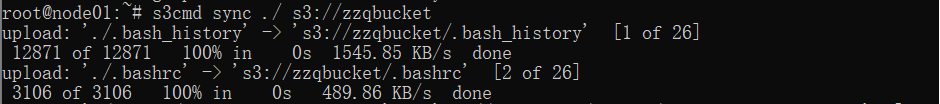
(13)对比指定目录下文件和bucket中文件并删除桶中差异文件(因为前面刚进行了同步,此时没有差异文件):
1
| s3cmd sync --delete-removed ./ s3://zzqbucket
|

(14)帮助命令:s3cmd --help
4.5.3 Python编程
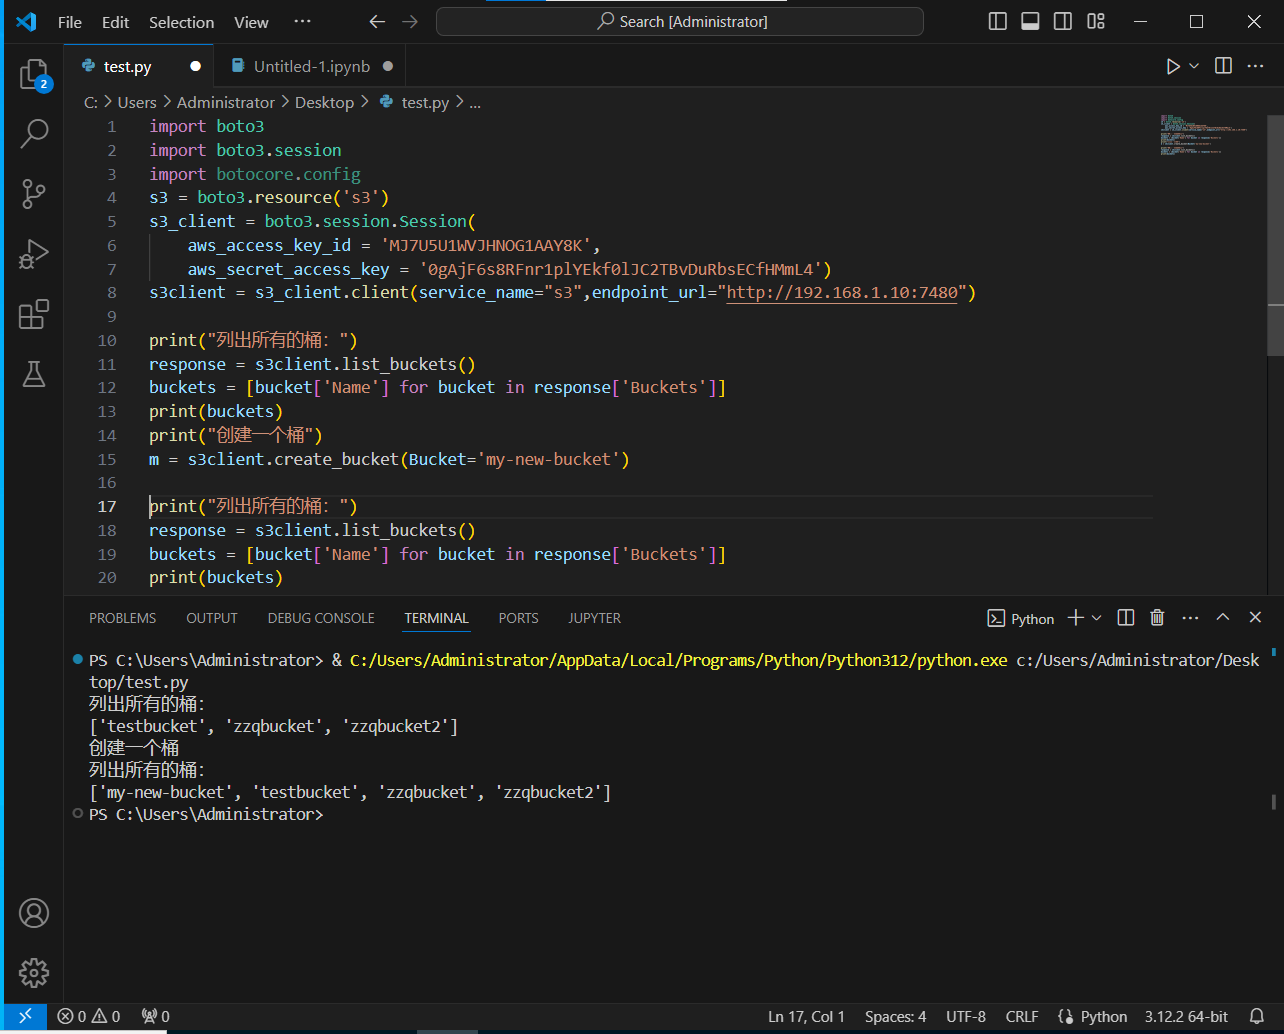
在使用Python访问对象存储时,我使用了前面使用的Window客户端,这台主机同样和集群处于一个内网,因此可以直接通过内网访问,并且在编程时更加方便,下面我编写了一个test.py文件,在vscode中进行运行。
我已经安装了Python3.12以及boto3,经过测试我发现有些语法需要按照boto3官方文档中的要求进行修改,这里附上文档链接:https://boto3.amazonaws.com/v1/documentation/api/latest/guide/quickstart.html。
程序内容和运行结果如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
| import boto3
import boto3.session
import botocore.config
s3 = boto3.resource('s3')
s3_client = boto3.session.Session(
aws_access_key_id = 'MJ7U5U1WVJHNOG1AAY8K',
aws_secret_access_key = '0gAjF6s8RFnr1plYEkf0lJC2TBvDuRbsECfHMmL4')
s3client = s3_client.client(service_name="s3",endpoint_url="http://192.168.1.10:7480")
print("列出所有的桶:")
response = s3client.list_buckets()
buckets = [bucket['Name'] for bucket in response['Buckets']]
print(buckets)
print("创建一个桶")
m = s3client.create_bucket(Bucket='my-new-bucket')
print("列出所有的桶:")
response = s3client.list_buckets()
buckets = [bucket['Name'] for bucket in response['Buckets']]
print(buckets)
|
到这里,Ceph 对象存储的图形界面访问、s3cmd 命令行操作和 Python 编程访问都已经完成。
五、一些记录
这次 Ceph 搭建覆盖了块存储、对象存储和文件存储三类接口。RBD 更适合云主机卷这类块设备场景,RGW 提供兼容 S3 的对象接口,CephFS 则提供共享文件系统能力。
从部署过程看,Ceph 的关键是网络、keyring、pool、daemon 名称和应用类型保持一致。Dashboard 对观察集群状态很有帮助,尤其是在排查 OSD、MDS、RGW 和 iSCSI 相关问题时。
这份记录可以作为后续重新搭建 Ceph 集群时的操作手册。
附录
搭建过程中参考过的资料:
[1] https://www.server-world.info/en/note?os=CentOS_Stream_9&p=ceph18&f=1
[2] https://zhuanlan.zhihu.com/p/671096663
[3] https://docs.ceph.com/en/reef/