看到 GPU 利用率不高,常见反应是增大 Block、提高 Occupancy、做算子融合或者直接换成 Triton。但这些动作如果没有性能模型支撑,很可能只是把瓶颈从一个地方搬到另一个地方。
可靠的优化过程应该像故障诊断:先建立理论上限,再用工具验证瓶颈,最后用实验确认收益。本文用同一套方法串起 Vector Add、Reduce、GEMM、Softmax、FlashAttention 和 LLM Decode。
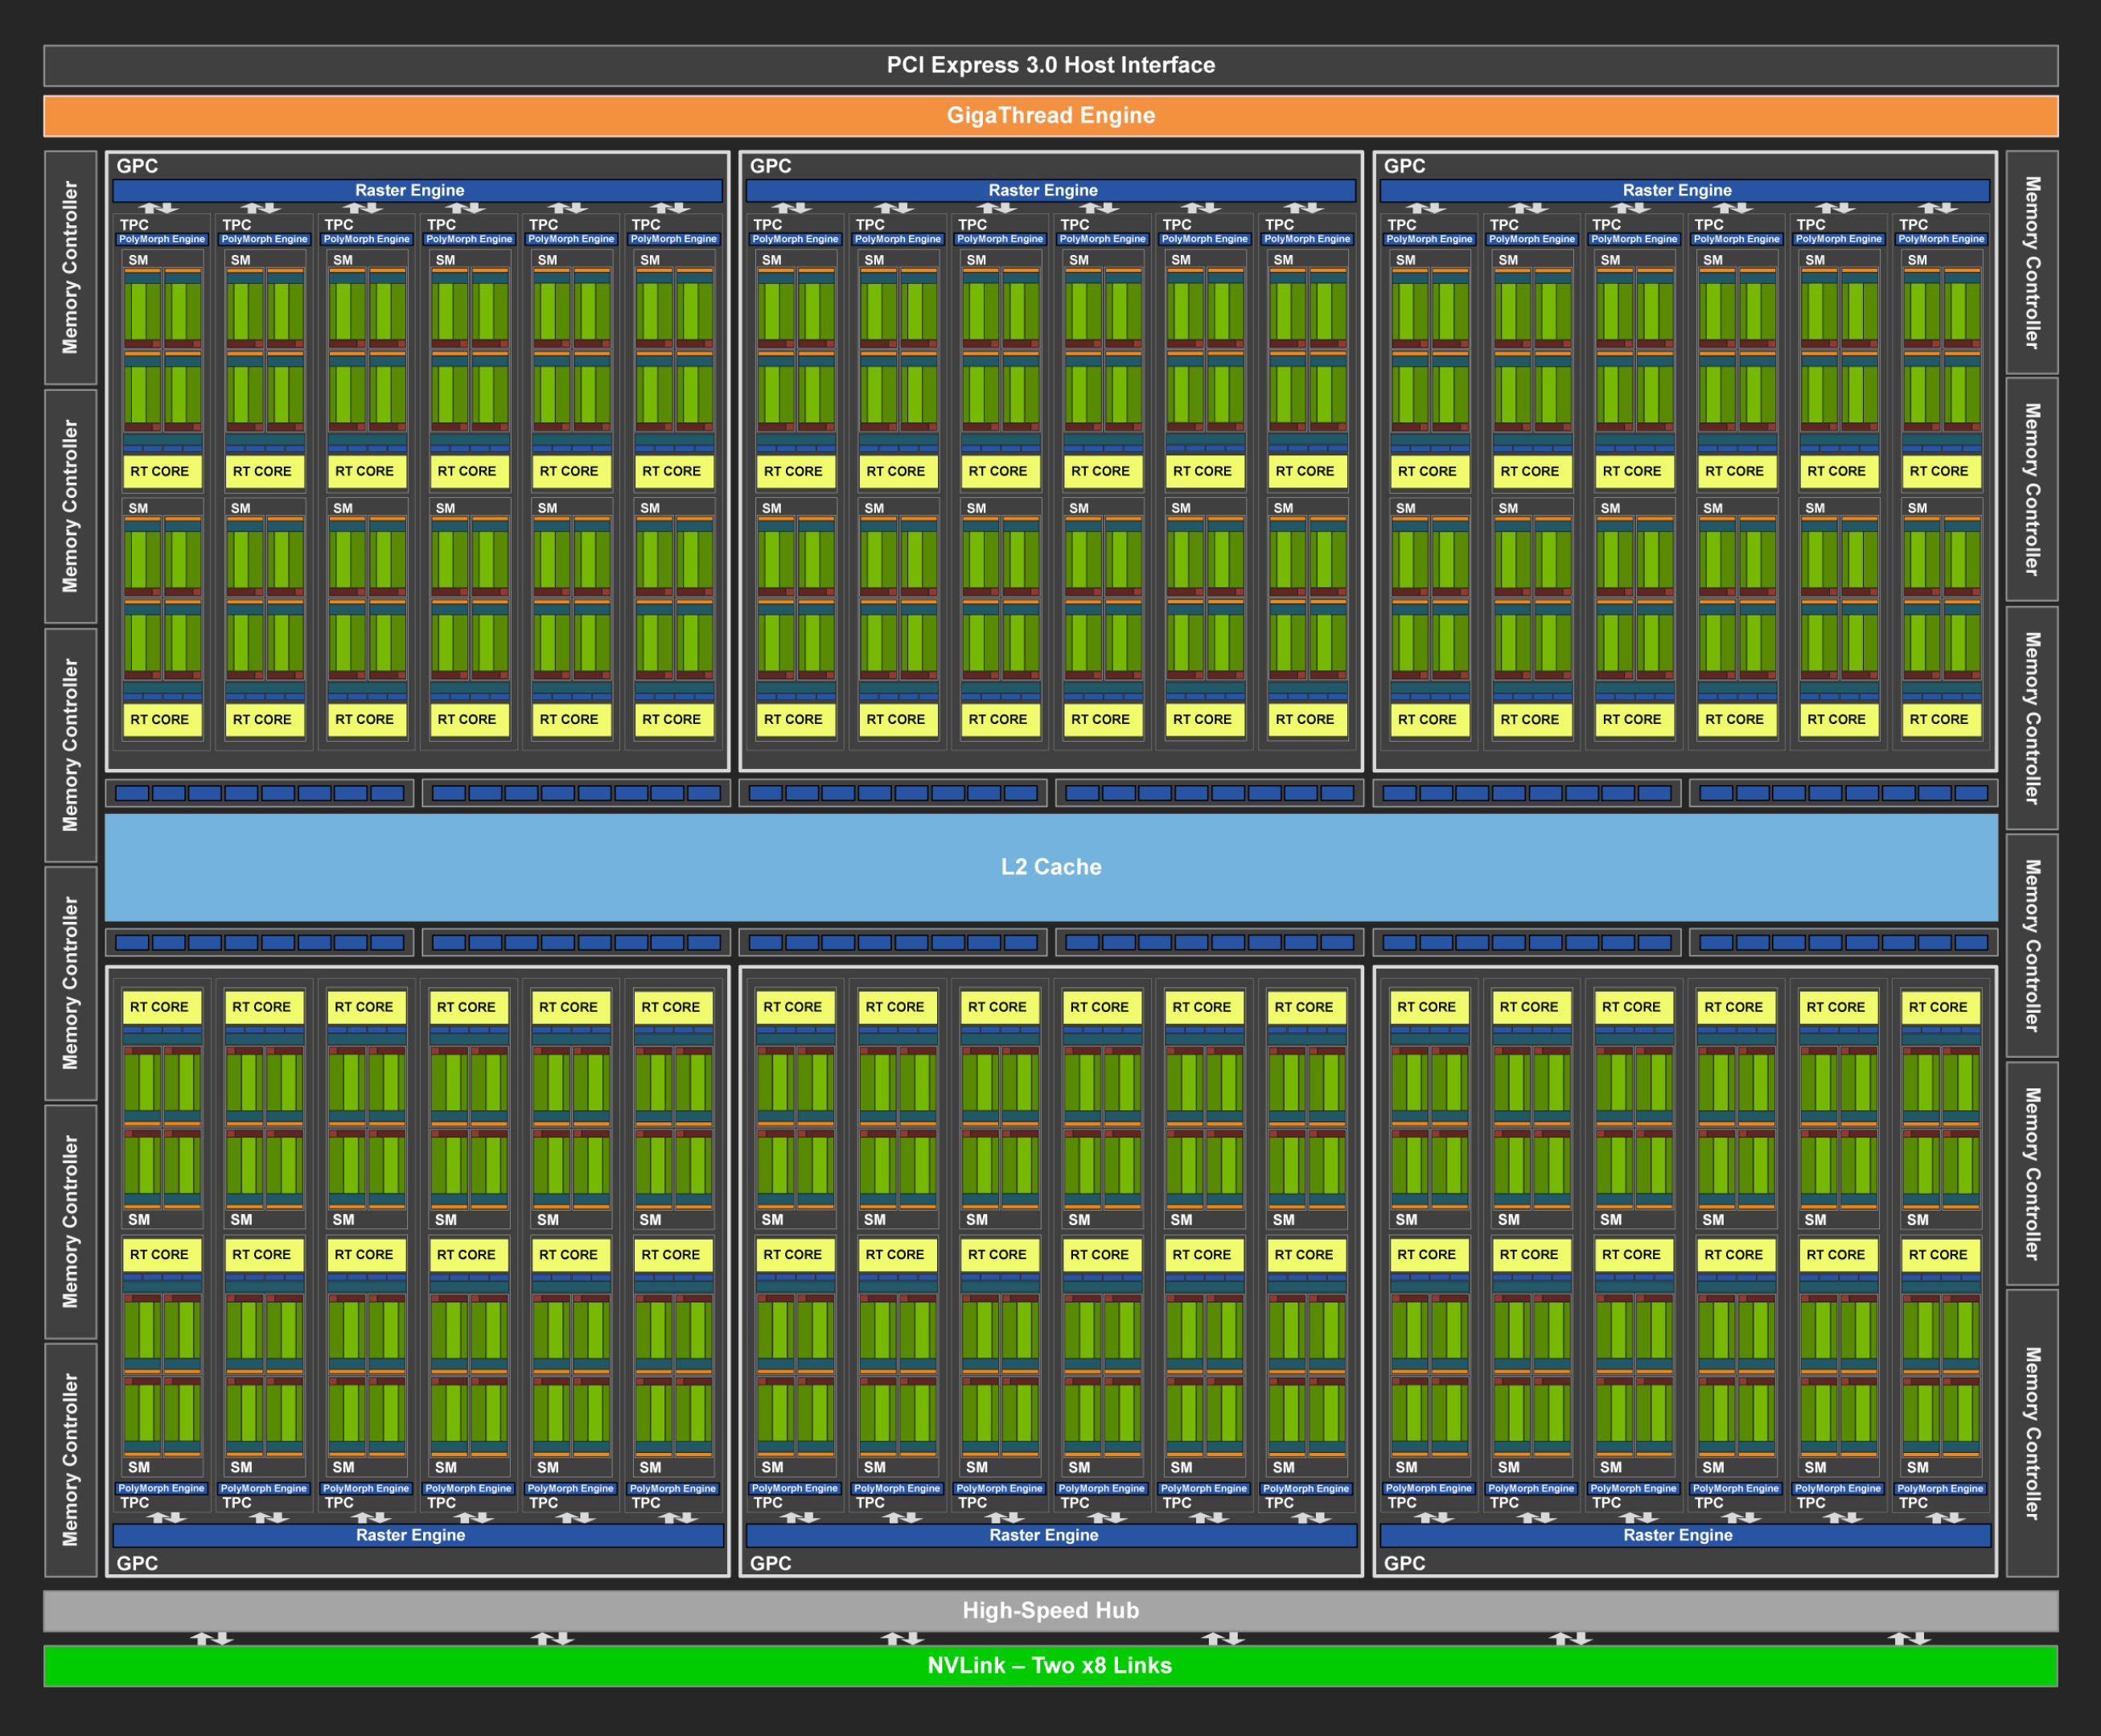
图 1:GPU 性能分析的对象不是抽象的“核”,而是 SM、执行单元和多级存储共同组成的系统。
一、性能问题先写成两个数字
对一个 Kernel,先估算:
- 总计算量:FLOPs;
- 最少数据搬运量:Bytes。
两者之比称为算术强度:
如果一个操作只做很少计算,却要从 HBM 读取大量数据,它通常受带宽限制;如果每次读取的数据会被重复使用很多次,它更可能受计算吞吐限制。
1.1 Vector Add
计算 C[i] = A[i] + B[i],每个元素读取两个 FP32、写回一个 FP32,共 12 Bytes,只执行一次加法:
这是典型的 Memory Bound 操作。继续增加算术单元不会明显加速,关键是合并访问、足够并发和接近峰值显存带宽。
1.2 GEMM
矩阵乘法包含大量乘加。如果通过 Shared Memory 和寄存器 Tiling 让数据被多次复用,算术强度可以大幅提高,最终接近 Compute Bound。
这两类操作构成了 Roofline 图上的两个极端。
二、Roofline:先判断优化方向
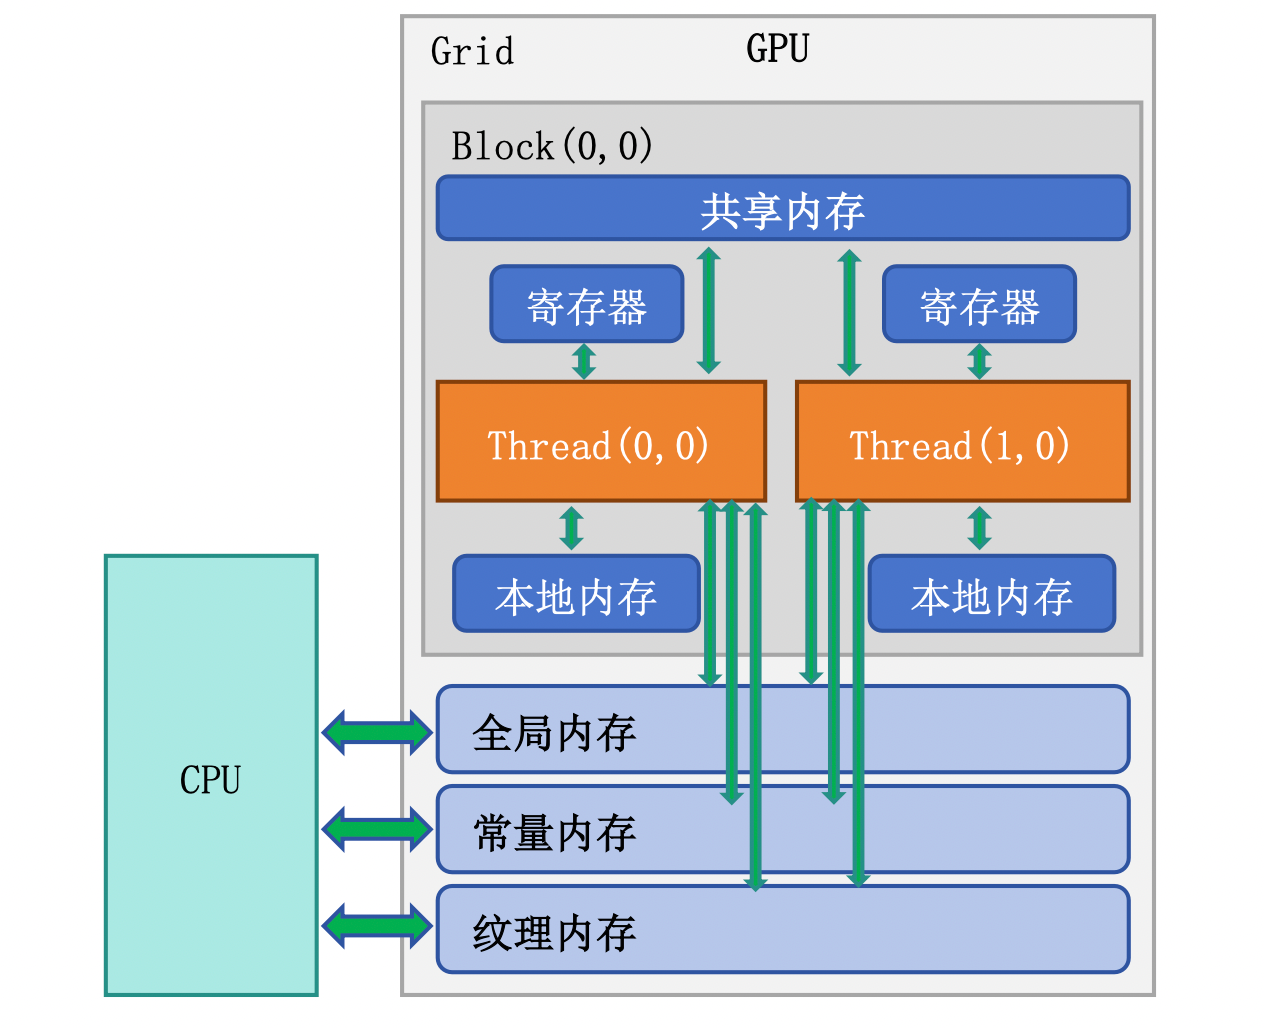
图 2:Roofline 中的“Bytes”来自不同存储层次;减少 HBM 流量和提高片上复用往往比减少一条算术指令更重要。
Roofline 模型给出的性能上限为:
其中 是峰值计算吞吐, 是峰值带宽。
1 | 性能 |
它不能直接告诉我们哪一行代码有问题,但能排除错误方向:
- 位于斜线区域:优先减少 HBM 访问、提高合并率和数据复用;
- 位于水平区域:优先提高 Tensor Core 使用率、指令并行和计算占用;
- 两个上限都远未达到:可能存在同步、分支、Launch、负载不均或数据准备问题。
2.1 一个带宽核算例子
对长度为 的 FP32 Vector Add,有效数据量为 Bytes。如果 ,Kernel 用时 2.4ms,则有效带宽约为:
这个数字必须与目标 GPU 在同一访问模式下的可达带宽比较,而不是简单除以产品手册峰值。如果向量起始地址未对齐、线程访问跨越更多内存事务或时钟频率受限,实际可达上限会下降。
类似地,GEMM 更适合报告 TFLOPS:
统一用“完成了多少必要工作/消耗了多少时间”描述性能,才能跨实现比较。
三、建立可信基线
优化前至少要保证四件事:
- 与参考实现比较正确性;
- 预热,排除首次初始化和编译;
- 使用 CUDA Event 测量 GPU 时间;
- 多次执行并报告中位数或分位数。
1 | cudaEventRecord(start); |
如果每轮都调用 cudaDeviceSynchronize(),测到的可能不再是实际流水执行方式。端到端延迟和纯 Kernel 延迟也应分开报告。
四、同一套方法看五类算子
4.1 Reduce:并行度和同步的平衡
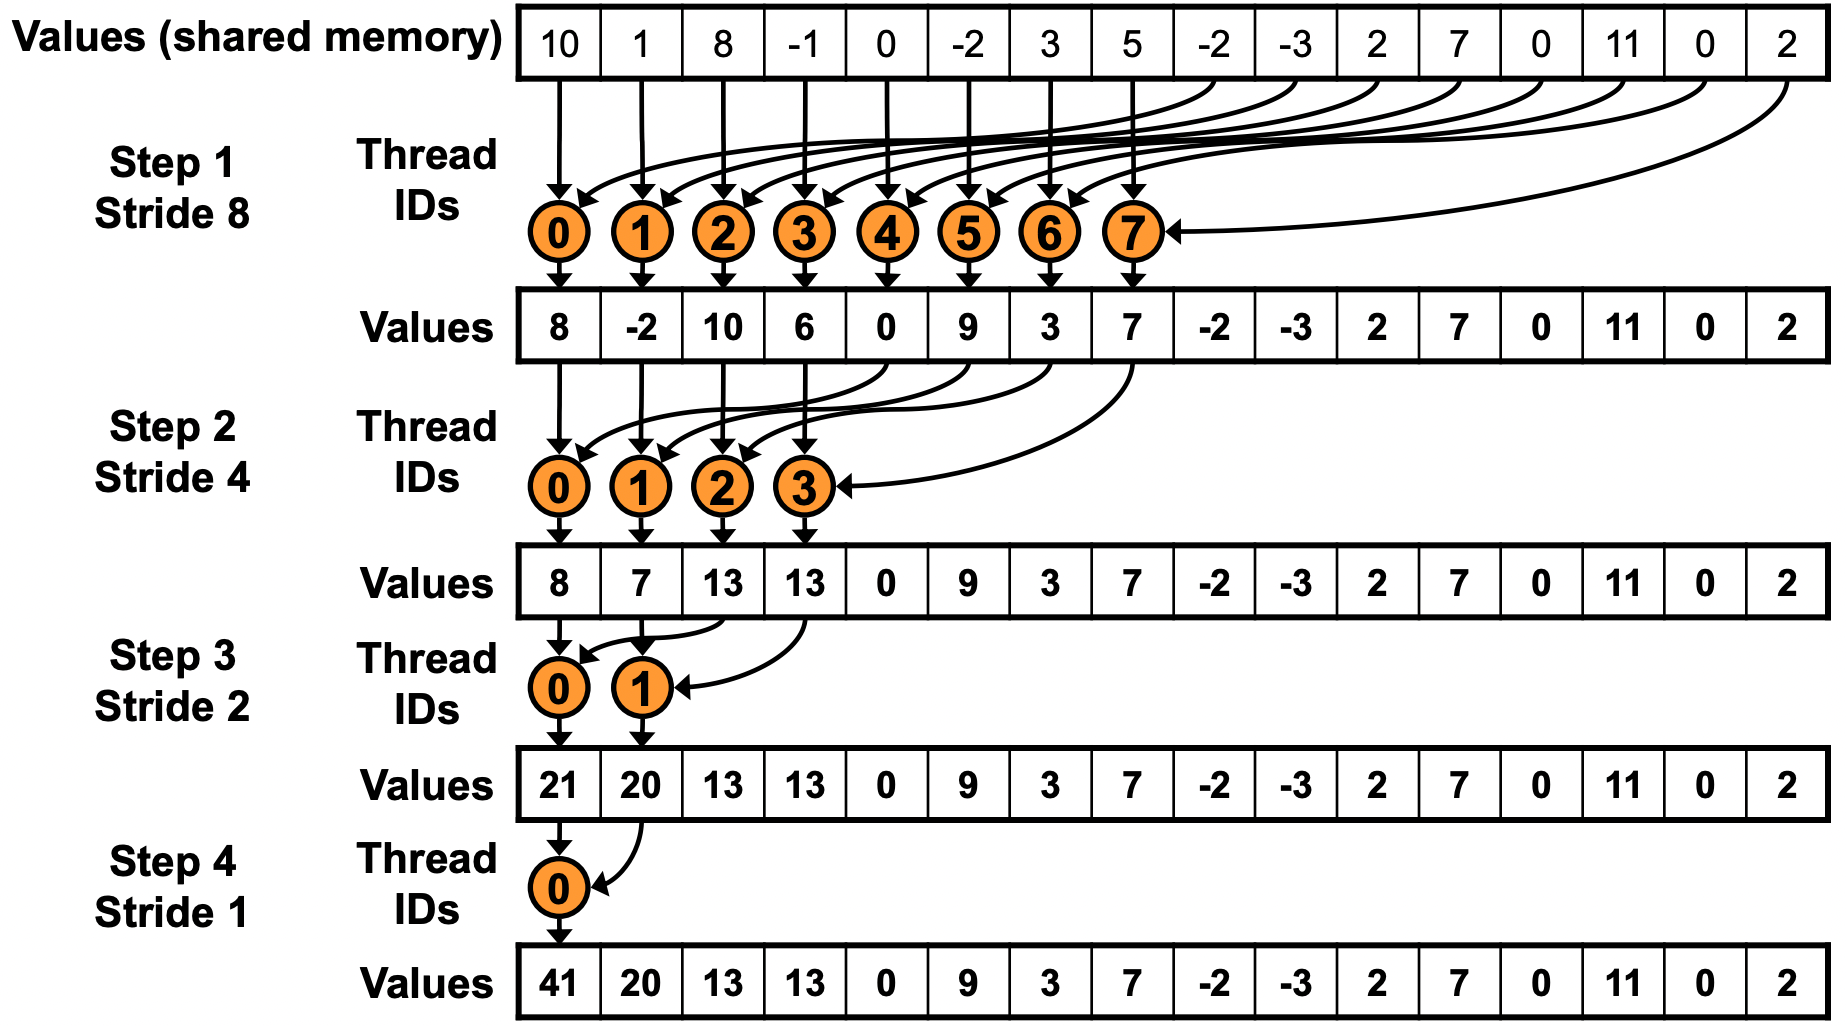
图 3:Warp Shuffle 将 Warp 内数据交换留在寄存器路径中,再用少量 Shared Memory 合并多个 Warp 的结果。
Reduce 的输入只读取一次,计算量很低,通常受带宽和规约开销影响。典型优化路径是:
1 | 全局原子加 |
每一步都应该对应一个可验证的假设。例如使用 Warp Shuffle 的目的,不是“它更高级”,而是减少 Shared Memory 访问和 Block 内同步。
4.2 GEMM:用空间换数据复用
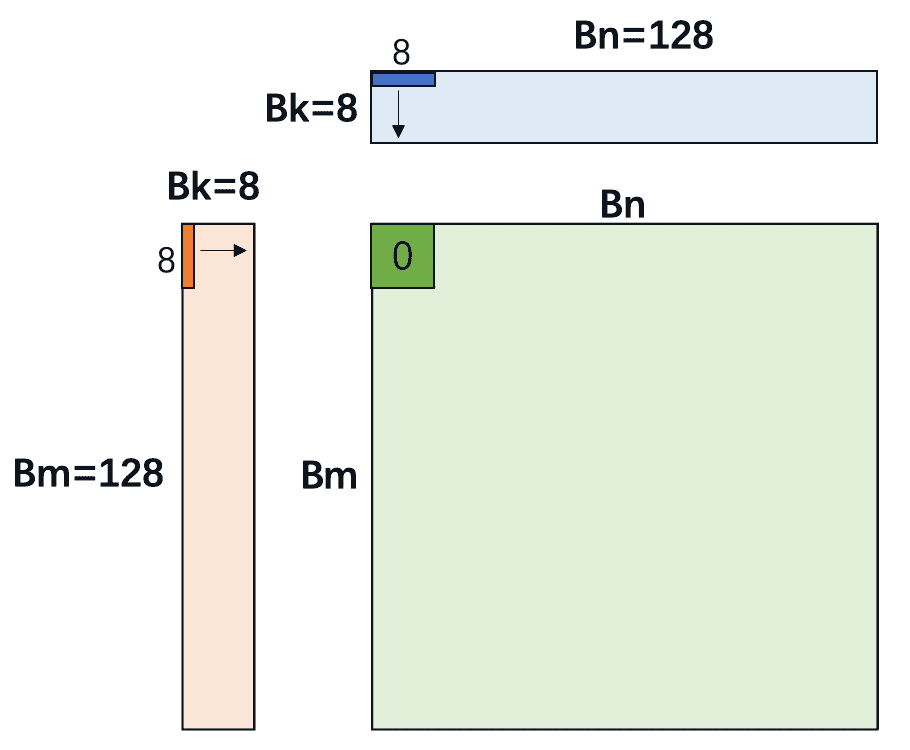
图 4:Thread Tiling 让一个线程计算多个输出元素,提高从 Shared Memory 到寄存器的数据复用。
朴素 GEMM 中,每个线程独立从全局内存读取一行和一列,数据重复读取严重。Block Tiling 把 A、B 的 Tile 搬入 Shared Memory;Thread Tiling 再把局部数据放入寄存器。
优化的代价也很明确:
- Tile 太小:复用不足;
- Tile 太大:Shared Memory 占用上升;
- 每线程输出太多:寄存器压力增大;
- 寄存器溢出:Local Memory 访问反而拖慢程序;
- Occupancy 降低:可能无法隐藏访存延迟。
因此 Occupancy 不是目标,而是资源预算的一部分。
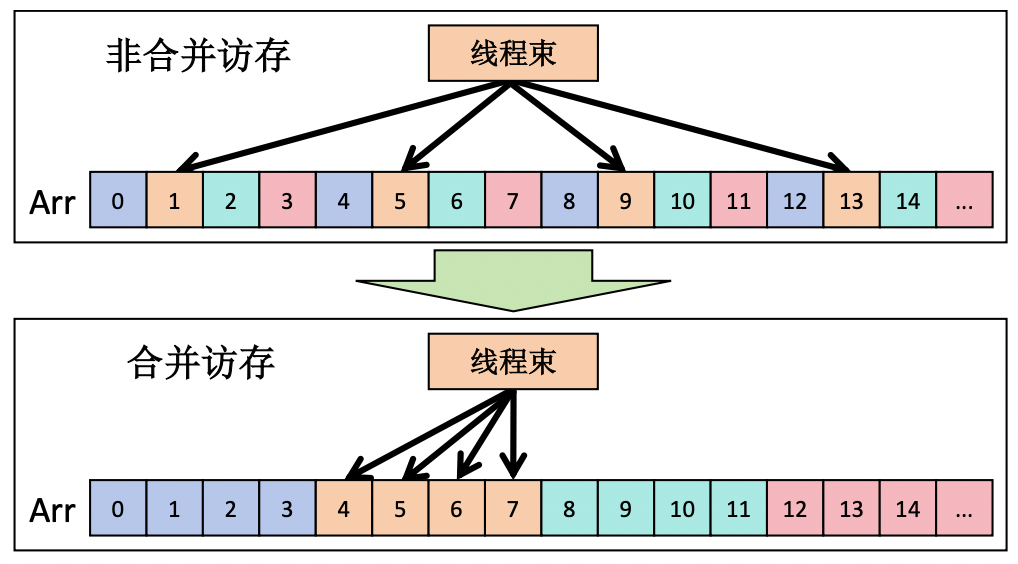
图 5:线程编号连续并不自动保证合并访存;关键是一个 Warp 请求的地址能否落入尽量少的内存事务。
4.3 Softmax:多遍扫描与规约
数值稳定的 Softmax 通常要完成:
- 求最大值;
- 计算指数和;
- 归一化输出。
这意味着多次读取同一行。Online Softmax 把最大值和指数和表示为可合并状态,减少扫描次数,并为 FlashAttention 的分块计算奠定基础。
4.4 FlashAttention:优化的不是 FLOPs
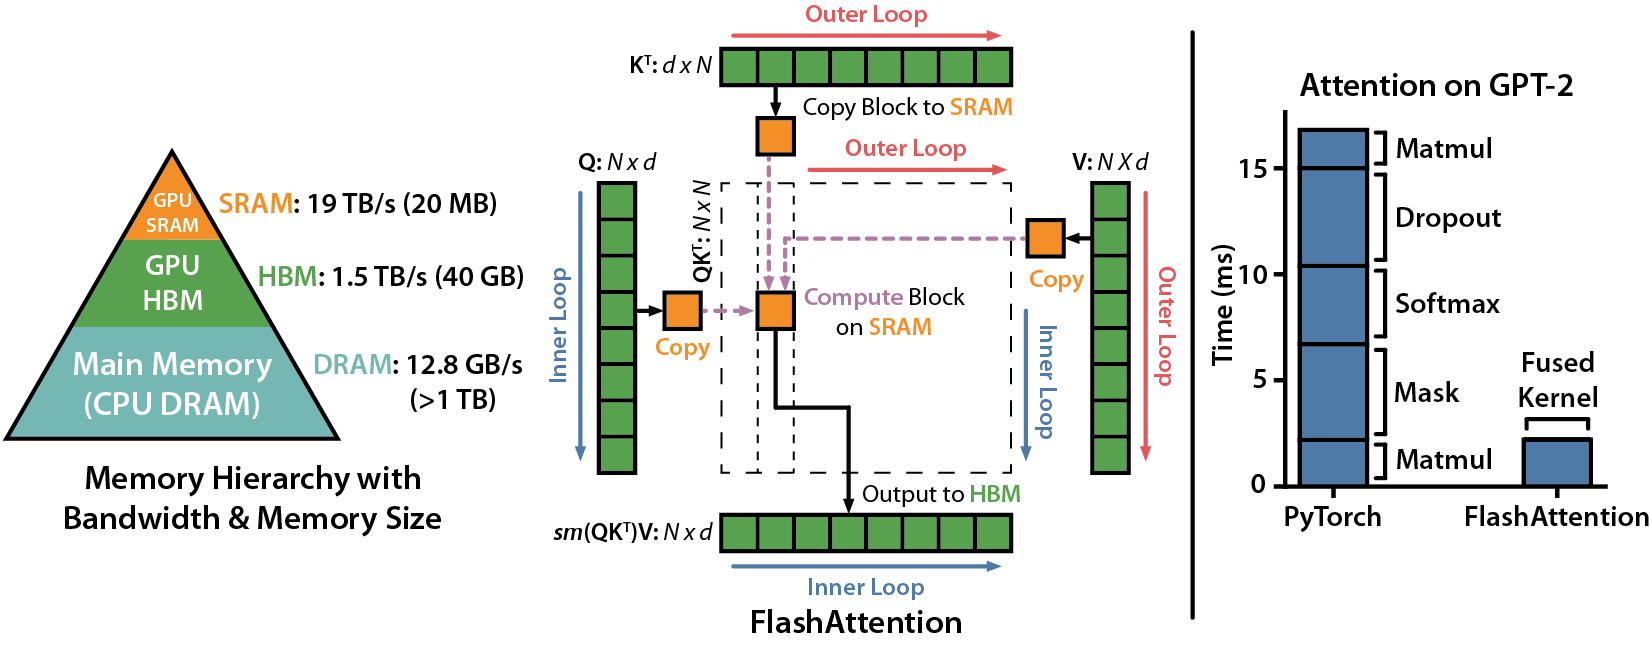
图 6:FlashAttention 的主要收益来自避免将完整 Attention 中间矩阵写回 HBM。
标准 Attention 会产生并写回 的分数或概率矩阵。FlashAttention 通过 Tiling 和 Online Softmax,让中间块停留在片上存储中。
它并没有改变精确 Attention 的数学定义,核心收益来自降低 HBM IO。这个例子非常适合说明:理论 FLOPs 相同的两个算法,真实速度可以完全不同。
4.5 Decode:Kernel 很快,系统仍可能很慢
LLM Decode 中的单个 Kernel 规模较小,CPU Launch、Python 调度和框架开销可能占据明显比例。此时只看 Kernel 内部指标是不够的,需要用 Nsight Systems 检查 GPU 时间线中的空洞。
CUDA Graph 可以录制并重放一组 Kernel,减少重复 Launch 开销。但它通常要求地址和形状相对稳定,也会增加捕获时间、显存占用和调试复杂度。
五、Nsight Systems:先看全局时间线
常用命令示例:
1 | nsys profile --trace=cuda,nvtx,osrt -o report ./app |
重点检查:
- Kernel 之间是否存在明显 GPU Idle Gap;
- CPU 是否在数据预处理、Python 或锁等待中停顿;
- Host-to-Device 拷贝能否与计算重叠;
- NCCL 通信是否与反向计算重叠;
- 是否存在大量极短 Kernel;
- 多个 CUDA Stream 是否真正并行。
Nsight Systems 适合回答“时间花在哪个阶段”,但不能完整解释某个 Kernel 为什么没有达到峰值。
六、Nsight Compute:下钻到单个 Kernel
1 | ncu --set full -o kernel-report ./app |
建议按下面顺序阅读:
6.1 Speed of Light
先比较计算吞吐和内存吞吐相对于设备峰值的比例。如果 Memory 接近上限而 Compute 很低,通常是 Memory Bound;反之则可能是 Compute Bound。
6.2 Memory Workload Analysis
检查:
- Global Load/Store 是否合并;
- 请求量与实际内存事务量是否相符;
- L1/L2 命中率;
- Shared Memory Bank Conflict;
- DRAM 吞吐是否接近有效上限。
6.3 Occupancy
确认限制 Active Warp 的资源:
- 每线程寄存器;
- 每 Block Shared Memory;
- Block 大小;
- 架构上的最大 Block 和 Warp 数。
高 Occupancy 可以帮助隐藏延迟,但不会自动提高算术强度或消除低效访存。
6.4 Warp Stall
不同架构和报告版本的指标名称可能变化,但常见信号包括:
- Long Scoreboard:Warp 长时间等待内存相关依赖;
- MIO Throttle:内存输入输出相关指令管线压力较大;
- Barrier:等待同步;
- Not Selected:有足够就绪 Warp,但当前没有被选中;
- Branch Resolving:分支控制流造成等待。
不要看到一个 Stall 指标高就直接下结论。它必须和访存事务、吞吐、Occupancy 以及源码位置一起解释。
七、一个可复用的优化闭环
第一步:定义目标
明确优化的是:
- 单 Kernel 延迟;
- 训练 Step Time;
- TTFT;
- TPOT;
- Tokens/s;
- 每美元吞吐。
第二步:建立模型
计算 FLOPs、Bytes、算术强度、理论带宽时间和理论计算时间。
第三步:获取证据
用 Systems 判断阶段,用 Compute 判断 Kernel,用框架 Profiler 补充算子和调用栈信息。
第四步:一次只修改一个变量
例如只改变:
- Block Size;
- Tile 大小;
- 向量化宽度;
- 是否融合;
- 是否使用 CUDA Graph。
第五步:记录收益和代价
至少记录正确性误差、延迟、吞吐、显存和适用输入范围。一个只在固定 Shape 上更快的 Kernel,不一定适合动态生产负载。
八、技术 Q&A
Q1:Occupancy 达到 100%,为什么 Kernel 仍可能很慢?
Occupancy 只描述 SM 上驻留 Warp 的比例,不描述每个 Warp 的访存是否合并、数据是否复用、指令是否有效或 Tensor Core 是否被使用。一个高 Occupancy Kernel 可以同时具有低算术强度、严重 Bank Conflict 和大量无效线程。只有当瓶颈是“没有足够就绪 Warp 隐藏延迟”时,提高 Occupancy 才直接有效。
Q2:Shared Memory Tiling 为什么能提高 GEMM 算术强度?
A、B 的一个 Tile 从 HBM 读取一次后,被 Block 内多个线程重复用于多个输出元素。必要 FLOPs 不变,而 HBM Bytes 减少,所以算术强度提高。Tile 继续增大时会消耗更多 Shared Memory 和寄存器,最终受 Occupancy、指令调度或片上带宽限制。
Q3:Nsight Systems 和 Nsight Compute 应该按什么顺序使用?
先用 Systems 判断端到端时间花在 CPU、数据拷贝、NCCL、Kernel 还是 GPU Idle;只有确认某个 Kernel 占据主要时间且内部效率不足后,再用 Compute 分析其内存事务、吞吐、Stall 和 Occupancy。直接对任意 Kernel 跑完整 NCU 容易得到大量指标,却没有优化优先级。
Q4:FlashAttention 的 FLOPs 相近为何仍能加速,而 Decode 的短 Idle Gap 又该如何处理?
标准 Attention 会把 分数或概率矩阵写入 HBM,再读回用于后续计算;FlashAttention 在 SRAM 中按 Tile 完成分数、在线归一化和与 V 的累加,避免物化大中间矩阵,因此通过减少 IO 获得加速。若 Decode 时间线的主要问题是 Kernel 之间存在大量短 Idle Gap,则瓶颈在 CPU 调度、同步或 Launch,此时应优先考虑 CUDA Graph、算子融合和减少框架往返,而不是继续优化已经很短的单个 Kernel。
九、系列导航
上一篇:LLM 自回归推理的执行路径
下一篇:LLM 推理引擎的内存管理与调度
十、参考资料
性能模型与硬件文档
- Roofline: An Insightful Visual Performance Model:算术强度与性能上限。
- NVIDIA CUDA C++ Programming Guide:CUDA 执行与内存模型。
- NVIDIA Deep Learning Performance Guide:深度学习工作负载性能分析。
- NVIDIA Nsight Systems User Guide:系统级时间线分析。
- NVIDIA Nsight Compute:Kernel 级性能指标。
算子优化
- CUTLASS:高性能 GEMM 模板和多级流水设计。
- How to Optimize a CUDA Matmul Kernel:从朴素实现到接近 cuBLAS 的优化过程。
- Online Normalizer Calculation for Softmax:Online Softmax 的递推状态。
- FlashAttention:IO-Aware Attention。
- FlashAttention-2:并行划分和非 GEMM 操作优化。
- Getting Started with CUDA Graphs:减少重复 Kernel Launch 开销。
- AIInfraGuide:CUDA 内存模型、Reduce/GEMM/Softmax 优化及 Nsight 工具链资料,MIT License。