高性能计算并不等于简单地“少算几步”。很多优秀算法做的事情,是利用数学等价关系改变计算顺序,让数据更适合硬件,同时避免浮点溢出和精度损失。
Softmax 是最典型的例子:从减最大值、Online Softmax 到 FlashAttention,数学公式没有改变,但数据扫描方式、并行规约方式和 HBM 访问量发生了根本变化。
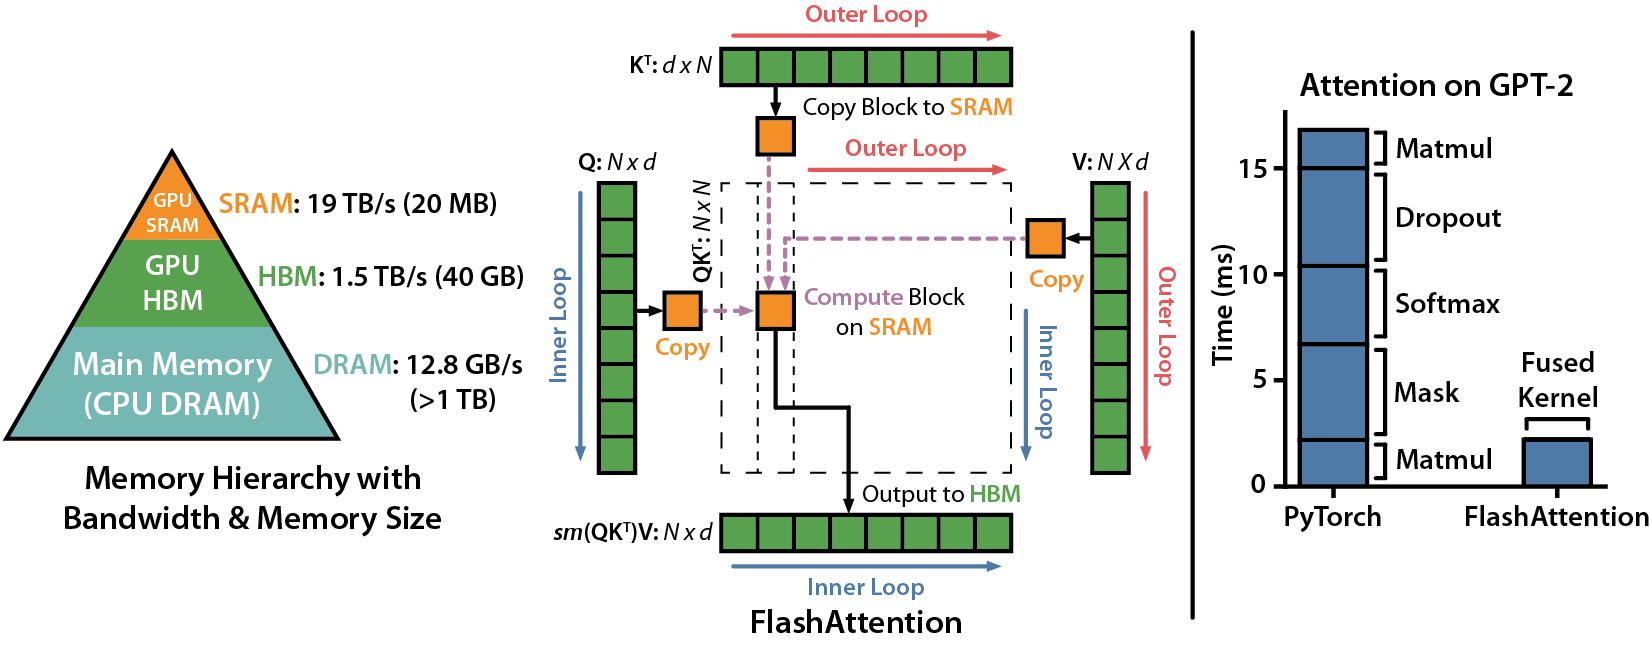
图 1:标准实现物化完整 Attention Matrix,FlashAttention 让 Tile 在片上完成归一化与输出累加。
一、浮点数同时受精度和范围限制
浮点格式可以粗略拆成符号位、指数位和尾数位:
- 指数位决定能表示的数量级范围;
- 尾数位决定相邻数字之间的精细程度。
FP16 的尾数精度和动态范围都小于 FP32,最大有限值约为 65504。BF16 的尾数更短,但指数范围与 FP32 接近,因此更不容易在大模型训练中发生溢出。
这解释了一个常见现象:BF16 的数值精度不一定高于 FP16,但训练稳定性往往更好,因为它保留了更大的指数范围。
1.1 浮点加法不满足严格结合律
数学上:
浮点运算中,舍入可能让两边得到不同结果。GPU 并行规约改变了加法顺序,所以同一个 Reduce Kernel 在不同 Block 划分、不同卡数甚至不同算法下,结果可能不逐位一致。
不逐位一致不等于错误。判断正确性要结合绝对误差、相对误差、数据类型和算法条件数。
二、朴素 Softmax 为什么会溢出
Softmax 定义为:
若某个 很大,exp(x_i) 可能溢出为无穷;如果输入很小,又可能下溢为 0。
2.1 减最大值
令 :
因为分子分母同时乘以 ,结果不变。所有 ,最大的指数项变成 1,从而避免正向溢出。
这不是经验技巧,而是严格的数学等价变换。
三、Safe Softmax 为什么需要三遍扫描
对一行长度为 的输入,常见实现是:
- 第一遍求最大值 ;
- 第二遍求 ;
- 第三遍输出 。
即使三遍计算都很简单,也要多次从内存读取同一行。在 GPU 上,Softmax 往往更受访存和规约限制,而不是指数计算本身。
如果一行较短,可以把输入暂存在寄存器或 Shared Memory;如果一行很长,缓存全部输入又会增加资源压力。
四、Online Softmax:维护一个可合并状态
逐个读取元素时,可以维护当前最大值 和归一化分母 :
当遇到更大的元素时,旧的指数和需要乘以 ,把它重新缩放到新的最大值基准。
4.1 两个局部状态如何合并
假设两段数据分别得到 和 ,合并状态为:
这个合并操作在精确数学中满足结合律,因此可以在线程、Warp 和 Block 层级做树形规约。浮点实现仍可能因为合并顺序不同产生细微误差。
下面的 Python 实现适合验证合并公式。把一行随机切成多个 Chunk,分别计算状态后反复合并,最终分母应与整行 Safe Softmax 一致:
1 | import math |
并行实现的关键不是把这个循环原样搬到 GPU,而是让每个线程先处理局部元素,再用 Shuffle 和 Shared Memory 执行同一个 merge_state。
4.2 GPU 上的层级规约
一种典型实现是:
1 | 每线程处理多个元素并得到局部 (m, l) |
与普通 Sum Reduce 不同,Online Softmax 规约的不是一个标量,而是带缩放规则的二元状态。
五、LayerNorm 与 RMSNorm 的数值问题
LayerNorm 对每个 Token 的隐藏维做归一化:
RMSNorm 省略均值中心化:
这些操作包含平方、求和和开方。若直接以低精度累积,大隐藏维下误差可能明显增加。因此常见 Kernel 会:
- 输入和输出使用 BF16/FP16;
- 局部统计量使用 FP32 累积;
- 采用 Welford 等稳定算法计算方差;
- 将 Residual Add、Norm 和类型转换融合,减少 HBM 往返。
算子融合的前提是数值语义明确。改变类型转换位置或规约顺序,可能让融合结果与拆分实现不再逐位一致。
六、混合精度训练为什么需要主权重
混合精度训练常见流程是:
1 | FP32 主权重 |
如果直接用 FP16 权重执行很小的更新,更新量可能因为尾数精度不足被舍入掉。FP32 主权重用于积累这些微小变化。
6.1 Loss Scaling
FP16 梯度可能下溢为 0。将 Loss 乘以缩放因子 ,梯度也会乘以 ;在 Optimizer Step 前再除以 ,可以把小梯度暂时移入 FP16 可表示范围。
动态 Loss Scaling 会在检测到 inf 或 nan 时降低缩放因子,在训练稳定时逐步增加。BF16 因为指数范围更大,通常不需要同样的 Loss Scaling,但仍要监控非有限值。
七、FlashAttention:把 Online Softmax 放进 Attention Tile
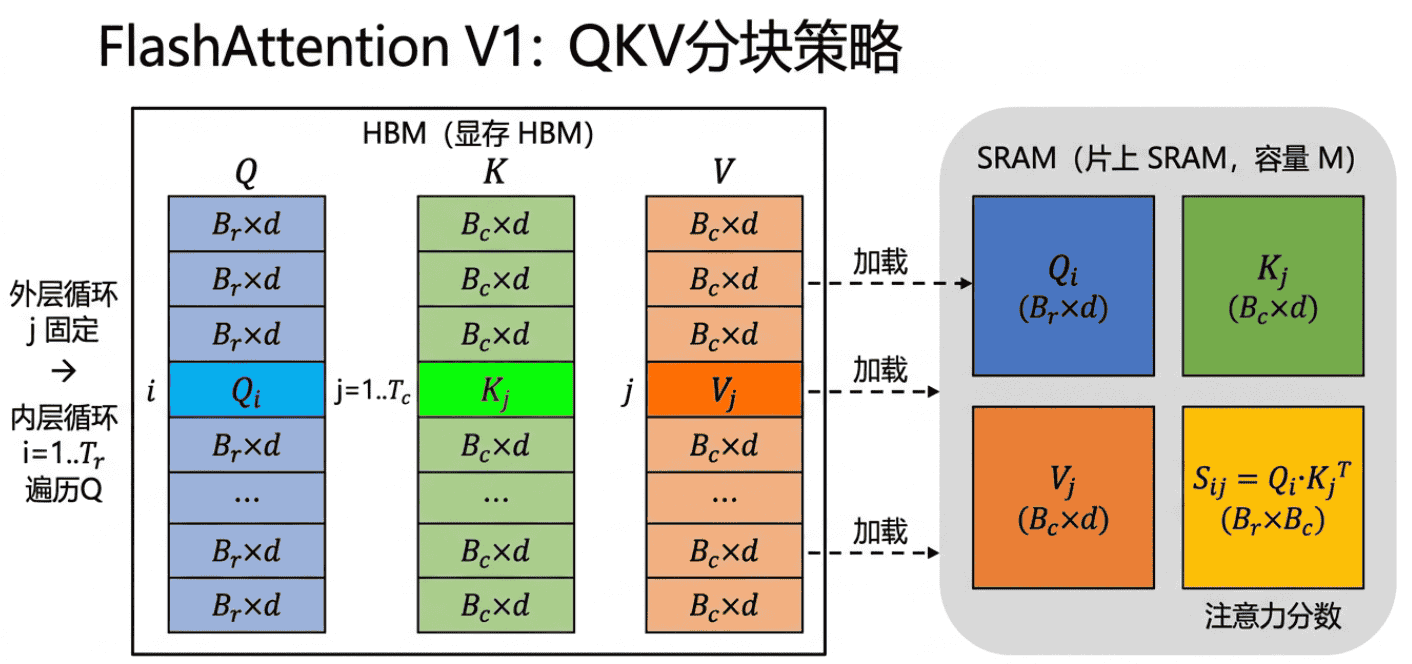
图 2:Q、K、V 按片上存储容量切块,每个 Q Tile 通过在线状态依次吸收 K/V Tile 的贡献。
标准 Attention 可以写成:
如果把完整 和 写入 HBM,序列长度为 时会产生 的中间数据。
FlashAttention 的核心流程是:
- 将 Q、K、V 切成可以放入片上存储的 Tile;
- 计算一个 小块;
- 更新当前行的 Online Softmax 状态;
- 按新的最大值重新缩放旧输出累加器;
- 累加当前概率块与 V Tile 的乘积;
- 不把完整 Attention Matrix 写回 HBM。
用算法状态表示,一个 Q Tile 的处理过程可以写成:
1 | 初始化:m = -∞,l = 0,O = 0 |
这里的 alpha 同时重缩放旧分母和旧输出累加器。只更新 l 而忘记缩放 O,会得到数值稳定但数学错误的 Attention。
对于输出累加器,还需要维护与 Softmax 分母一致的缩放关系。新的 Tile 如果抬高了行最大值,旧输出也要乘以相应缩放因子,然后才能与当前 Tile 的贡献相加。
7.1 为什么它仍是精确 Attention
FlashAttention 没有丢弃 Token,也没有近似概率矩阵。它只是利用 Online Softmax 的可合并状态,改变了计算和数据搬运顺序。因此在浮点误差允许范围内,它计算的是同一个 Attention。
7.2 为什么反向可以重计算
标准实现可能保存巨大的概率矩阵供反向使用。FlashAttention 保存更少的统计量,反向时重新计算局部分数。
这看起来增加了 FLOPs,却减少了更昂贵的 HBM 读写。只要重计算发生在高吞吐矩阵运算中,Wall-clock 时间仍可能更短。
八、V2 为什么继续优化工作划分
FlashAttention-2 没有推翻 V1 的数学核心,主要改进包括:
- 调整 Q 与 K/V 的循环组织,让输出不必反复写回 HBM;
- 减少非矩阵乘法相关的缩放和同步;
- 改变 Warp 之间的工作分配,减少 Shared Memory 通信;
- 对 Causal Mask 的无效块进行跳过。
这说明算法优化不仅要考虑大 O 复杂度,还要考虑硬件上不同指令的吞吐差异。Tensor Core GEMM 很快,并不代表标量指数、同步和数据搬运同样便宜。
九、正确性测试应该怎么做
一个高性能 Kernel 至少需要四类测试:
9.1 参考实现
用 PyTorch 或高精度 CPU 实现作为基准,对比 Forward 和必要的 Gradient。
9.2 极端输入
- 很大的正数;
- 很大的负数;
- 全部相等;
- 一行只有一个元素;
- 非对齐长度和尾块;
- 包含 Mask 的边界情况。
9.3 误差标准
同时报告绝对误差和相对误差。容限应根据 FP32、BF16、FP16 以及累积长度设置,不能用一套阈值覆盖所有情况。
9.4 性能与精度一起记录
只报告速度而不报告误差没有意义。推荐保存:
| Shape | dtype | 最大绝对误差 | 最大相对误差 | 延迟 | 带宽/TFLOPS |
|---|
十、技术 Q&A
Q1:稳定 Softmax 为什么要减去最大值,Online Softmax 又如何合并局部状态?
在 Softmax 的分子和分母中同时乘以 不会改变结果。选择 后,所有指数输入都不大于零,从而避免正向溢出。合并两个局部状态时,先取 ,再把两段分母重缩放到同一基准:。局部 分别对应不同的指数尺度,不能直接相加。
Q2:合并公式在数学上满足结合律,为什么 GPU 结果仍可能不逐位一致?
公式在实数域等价,但浮点乘加、指数和规约的每一步都会舍入。不同 Warp/Block 划分会改变合并树,因此也会改变舍入误差的累积顺序。正确性测试应使用与 dtype 相匹配的误差容限和高精度参考,不能要求所有并行配置得到相同的 bit pattern。
Q3:FP16 为什么常需要 Loss Scaling,而 BF16 通常不需要?
FP16 的指数位较少,小梯度更容易下溢成零;Loss Scaling 先放大损失和梯度,更新前再按相同比例缩回。BF16 与 FP32 具有相同宽度的指数部分,动态范围大得多,通常不需要用同样方法避免下溢。不过 BF16 的尾数更短,仍然存在明显的舍入误差,因此“通常不需要 Loss Scaling”并不等于“数值精度等同于 FP32”。
Q4:FlashAttention 为什么仍是精确 Attention,重计算增加 FLOPs 又为何可能更快?
FlashAttention 没有稀疏化或截断 Attention,而是使用 Online Softmax 的等价缩放公式合并不同 K/V Tile,数学目标没有改变。它避免把巨大的 Attention Probability 写入 HBM 并再次读回;反向时宁可重算部分局部结果,也不保存这些中间张量。由于 GPU 的矩阵计算吞吐远高于 HBM 的数据供给速率,把低带宽的数据搬运替换为高吞吐计算,即使 FLOPs 增加,总时间仍可能下降。
十一、系列导航
上一篇:分布式训练的通信模型
十二、参考资料
数值计算与归一化
- What Every Computer Scientist Should Know About Floating-Point Arithmetic:浮点误差、舍入和异常值的经典介绍。
- Mixed Precision Training:主权重和 Loss Scaling。
- Layer Normalization:LayerNorm 原始论文。
- Root Mean Square Layer Normalization:RMSNorm。
- On Layer Normalization in the Transformer Architecture:Pre-Norm 与 Post-Norm。
Softmax 与 Attention
- Online Normalizer Calculation for Softmax:Online Softmax 状态及合并公式。
- FlashAttention:IO-Aware Exact Attention。
- FlashAttention-2:并行划分和工作分配优化。
- FlashAttention Official Repository:实现、测试和 Benchmark。
- CUDA Warp Shuffle Functions:Warp 级状态交换。
- AIInfraGuide:数学基础、混合精度、Online Softmax 与 FlashAttention 的中文推导和实现资料,MIT License。